Eksamensoppgavene er utgitt av Utdanningsdirektoratet. Første nedlasting kjører en bot-sjekk i nettleseren (Vercel BotID) — mer i personvernerklæringen.
Oppgave 1-1·Standardform, potensregning, statistikk og sannsynlighet H11 del1
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
a)
Skriv på standardform
b)
Regn ut
1)
2)
Politiet har gjennomført en fartskontroll i 30 km-sonen utenfor skolen. Resultatene er gitt i tabellen nedenfor.
Fart
Antall biler
20
20
10
c)
Finn gjennomsnittsfarten.
Ivar plukker moreller. Den grafiske framstillingen nedenfor viser hvor mye han tjener i løpet av en time når han plukker .
d)
Forklar hvordan lønnen til Ivar blir beregnet.
I en klasse er det 10 elever. På en matematikkprøve fikk elevene karakterene
e)
Finn medianen, gjennomsnittet og variasjonsbredden.
For 6 måneder siden kjøpte Snorre aksjer. Nedenfor har han regnet ut hva verdien av aksjene er i dag.
f)
Hva kan regnestykket fortelle om hvordan verdien av Snorres aksjer har endret seg?
Eva har én pakke blåbærgelé, to pakker kiwigelé, to pakker sitrongelé og tre pakker bringebærgelé.
Hun tar tilfeldig to pakker gelé.
g)
1)
Hva er sannsynligheten for at den første pakken hun tar, er kiwigelé?
2)
Hva er sannsynligheten for at hun tar to pakker kiwigelé?
3)
Hva er sannsynligheten for at hun tar én pakke kiwigelé og én pakke blåbærgelé?
Kine og Mina har deltatt i en svømmekonkurranse. Nedenfor ser du en forenklet grafisk framstilling av svømmeturen til Kine (blå graf) og svømmeturen til Mina (rød graf).
h)
Hva kan du si om de to svømmeturene ut fra grafene?
Fasit
a)
b)
1) 2)
c)
d)
e)
Median , gjennomsnitt , variasjonsbredde
f)
Verdien av aksjene har både økt og sunket i ulike perioder, og samlet sett har verdien falt fra til ca.
g)
1) 2) 3)
h)
Kine er raskest ut til vendepunktet, men Mina svømmer raskest tilbake og vinner konkurransen
LøsningsforslagKI-generert
a)
Vi flytter kommaet slik at vi får ett siffer foran komma, og teller hvor mange plasser vi har flyttet det.
Kommaet er flyttet plasser mot høyre, så eksponenten blir .
b)1)
Vi bruker at .
2)
Vi regner ut hvert ledd for seg.
c)
For å finne gjennomsnittsfarten fra en gruppert tabell bruker vi midtpunktet i hvert intervall som representativ verdi, ganger med antallet biler i intervallet, summerer og deler på totalt antall biler.
Fart
Midtpunkt
Antall biler
Midtpunkt antall
Sum
d)
Vi leser av grafen. Når (Ivar plukker ingen moreller), er lønnen . Det betyr at Ivar har en fast grunnlønn på per time, uansett hvor mye han plukker.
Vi leser videre av at grafen går gjennom punktene og . Stigningstallet blir da
Lønnen øker altså med for hver ekstra moreller Ivar plukker. Sammenhengen blir
Lønnen til Ivar blir beregnet som en fast grunnlønn på pluss per kilo moreller han plukker.
e)
Vi sorterer karakterene i stigende rekkefølge.
Median: Det er verdier, så medianen er gjennomsnittet av den og verdien.
Gjennomsnitt: Vi summerer alle karakterene og deler på antallet.
Variasjonsbredde: Differansen mellom høyeste og laveste verdi.
f)
Regnestykket viser verdiendringen til aksjene over måneder, delt inn i tre perioder med ulike vekstfaktorer:
betyr en økning på (én periode, f.eks. én måned).
betyr en økning på i hver av to påfølgende perioder.
betyr en nedgang på i hver av tre påfølgende perioder.
Til sammen dekker periodene måneder. Verdien steg altså litt de første månedene, men falt kraftig ( per måned) de tre siste månedene. Selv om aksjene økte i verdi i starten, endte de samlet sett med å synke i verdi, fra til om lag .
g)
Eva har totalt pakker gelé, hvorav er kiwigelé og er blåbærgelé. Hun tar pakkene uten tilbakelegging.
1)
Sannsynligheten for at den første pakken er kiwigelé:
2)
Sannsynligheten for at begge pakkene er kiwigelé. Etter at én kiwipakke er tatt, er det pakker igjen, hvorav kiwi.
3)
Sannsynligheten for én kiwi og én blåbær kan skje i to rekkefølger: kiwi først eller blåbær først.
Vi legger sammen sannsynlighetene for de to rekkefølgene:
h)
Vi leser av grafene til Kine (blå) og Mina (rød).
Kine sin avstand fra start øker raskt og når toppunktet på ca. etter ca. sekunder. Deretter avtar avstanden jevnt, og Kine er tilbake ved start etter ca. sekunder.
Mina sin avstand øker litt saktere enn Kines i starten, og hun når sitt toppunkt på ca. først etter ca. sekunder. Deretter svømmer hun raskere tilbake enn Kine, og er tilbake ved start allerede etter ca. sekunder.
Begge svømmer altså like langt ut (ca. ) før de snur. Kine er raskest ut, men Mina er raskere på veien tilbake. Siden Mina er tilbake ved start etter kortest tid totalt, vinner Mina svømmekonkurransen.
Sensorveiledning
Oppgaven gir til sammen 18 poeng
d)2p2 poeng
Et kvalitativt svar gir full uttelling.
h)2p2 poeng
For å få full uttelling må eleven ha med minst tre momenter.
Oppgave 1-2·Eventyrkjeks salg i kvartal – lage diagrammer
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
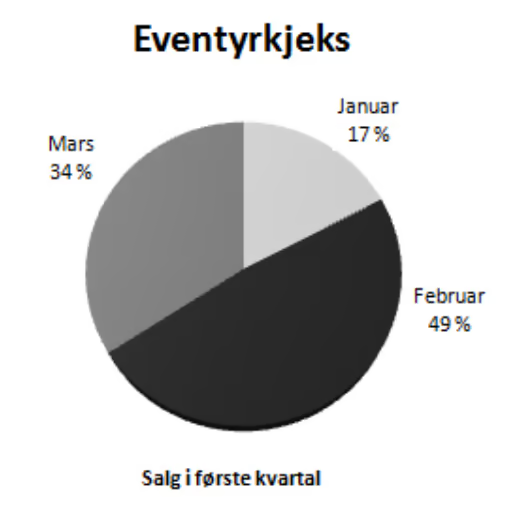
Per, Pål og Espen selger pakker med Eventyrkjeks. Diagrammene nedenfor viser resultater fra første kvartal 2011.
a)
Bruk opplysningene i tabellen nedenfor til å lage tilsvarende diagrammer for andre kvartal 2011.
Salg i andre kvartal
April
Mai
Juni
Per
225
90
450
Pål
675
180
450
Espen
0
630
900
b)
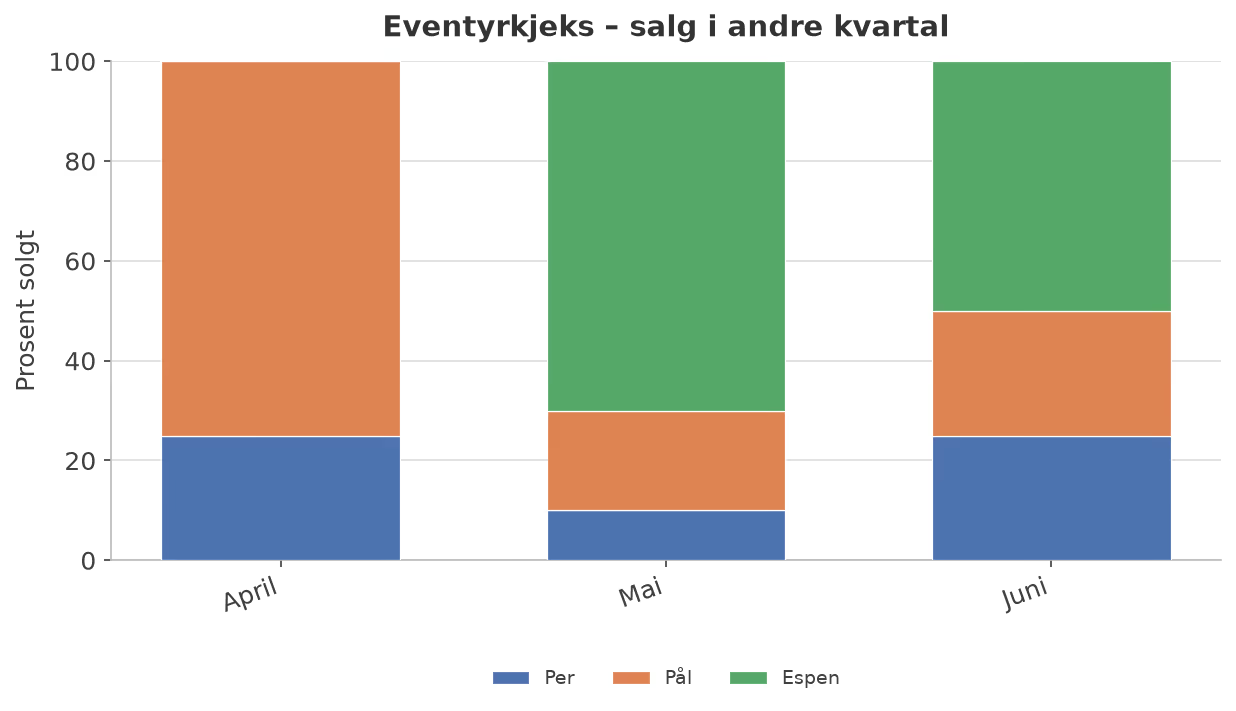
Lag et diagram for andre kvartal som viser hvor mange pakker med Eventyrkjeks hver av de tre guttene solgte hver måned.
Fasit
a)
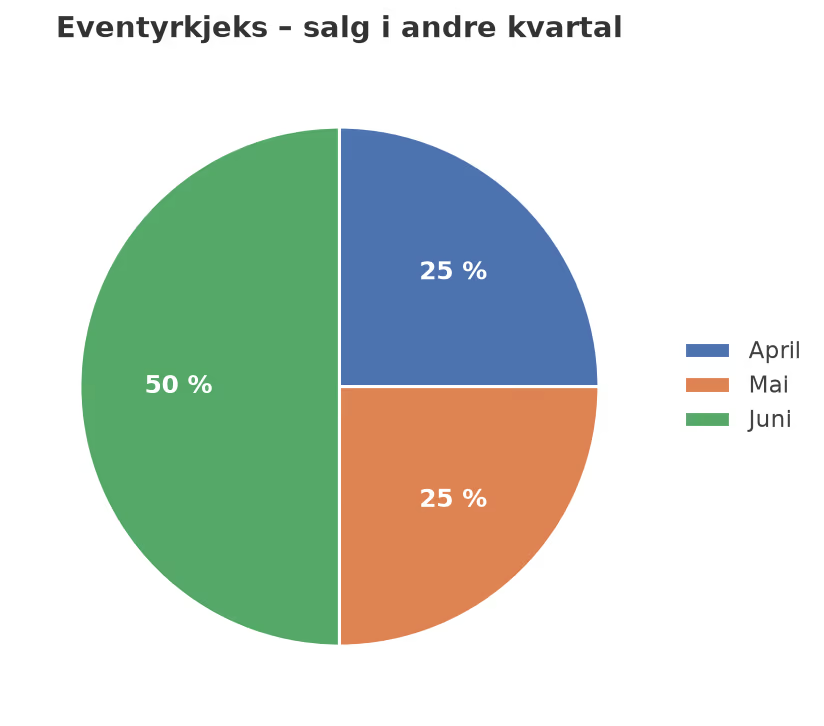
Sektordiagram: April (), Mai (), Juni ().
b)
Stablet stolpediagram med prosentandeler per selger per måned, se figur.
LøsningsforslagKI-generert
a)
Vi finner først totalt salg per måned i andre kvartal:
Totalt salg i andre kvartal er pakker.
I sektordiagrammet for første kvartal viser hver sektor hvor stor andel av kvartalets totale salg som ble solgt i den aktuelle måneden. Vi bruker samme fremgangsmåte for andre kvartal: finner andelen til hver måned, og ganger med for å finne sektorvinkelen.
Dette gir sektordiagrammet:
I regneark lages diagrammet ved å markere tabellen med månedene og totalsalget, og deretter sette inn et sektordiagram (kakediagram). Regnearket regner selv ut prosentandelene.
b)
I det stablede stolpediagrammet for første kvartal viser hver søyle av salget i den måneden, delt opp i hvor stor andel hver av de tre selgerne stod for. Vi bruker samme fremgangsmåte for andre kvartal.
For hver måned regner vi ut hvor stor prosentandel av salget hver gutt hadde, ved å dele hans salg på månedens totalsalg:
Dette gir det stablede stolpediagrammet:
I regneark lages diagrammet ved å markere tabellen med salgstall for alle tre guttene fordelt på måned, og deretter sette inn et stablet stolpediagram med -stabling. Regnearket regner selv ut prosentandelene og stabler søylene slik at hver søyle går opp til .
Oppgave 2-3·Bibliotekgebyr med lineær og geometrisk vekst
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Nils har funnet en bok på loftet. Tippoldefaren til Nils lånte boka på biblioteket og skulle levert den inn igjen 23.11.1911.
Nils lurer på hvor dyrt dette kunne blitt for tippoldefar dersom biblioteket hadde beregnet gebyr for sen innlevering. Han ser for seg at biblioteket kunne beregnet gebyr etter to ulike modeller.
Modell 1
Et gebyr på 10 øre en uke etter at boka skulle vært levert inn igjen, og så 5 øre i tilleggsgebyr for hver uke som går etter det. (Det vil si at dersom boka hadde blitt levert tre uker for sent, ville gebyret vært på totalt 20 øre.)
Modell 2
Et gebyr på 10 øre en uke etter at boka skulle vært levert inn igjen, og deretter øker dette gebyret med 0,2 % hver uke. (Det vil si at dersom boka hadde blitt levert tre uker for sent, ville gebyret vært på totalt 10,04004 øre.)
I denne oppgaven regner vi at det er 52 uker i et år.
a)Hjelpemiddelkrav: Kalkulator
Tenk deg at tippoldefar leverer inn boka i dag.
1)
Hvor mye måtte han ha betalt i gebyr dersom biblioteket hadde brukt modell 1?
2)
Hvor mye måtte han ha betalt i gebyr dersom biblioteket hadde brukt modell 2?
b)Hjelpemiddelkrav: Kalkulator
For hvilken av de to modellene kommer gebyret raskest opp i 10 kroner?
Fasit
a)
(modell 1) og (modell 2)
b)
Modell 1 når først, (modell 2 bruker uker)
LøsningsforslagKI-generert
a)
Boka skulle vært levert , og i dag (eksamensåret) er den omtrent år forsinket. Med uker i året tilsvarer dette
Modell 1 er en aritmetisk rekke med startledd øre (uke 1) og differanse øre per uke. Gebyret etter uker er
For :
Modell 2 er en geometrisk rekke med startledd øre og vekstfaktor per uke. Gebyret etter uker er
For :
Med modell 1 måtte tippoldefar betalt , mens han med modell 2 måtte betalt hele i gebyr.
b)
Vi finner hvor mange uker det tar før gebyret når øre () i hver av modellene.
Modell 1: Vi løser :
Etter uker er gebyret nøyaktig i modell 1.
Modell 2: Vi løser :
Siden må være et helt antall uker, tar det uker før gebyret i modell 2 passerer .
Siden , er det som først når i gebyr — allerede etter uker, mens modell 2 bruker over uker på grunn av den langsommere prosentvise starten.
Sensorveiledning
Oppgaven gir til sammen 6 poeng
a)4p4 poeng
Ved grafisk løsning skal avlesning markeres tydelig. Dette gjelder også ved bruk av digitale verktøy.
b)2p2 poeng
Ved grafisk løsning skal avlesning markeres tydelig. Dette gjelder også ved bruk av digitale verktøy.
En systematisk «prøve og feile»-metode bør gi uttelling. (Se Vurderingsveiledning 2011.)
Oppgave 2-4·Mayaindianernes tallsystem med grunntall 20
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Mayaindianerne i Mellom-Amerika utviklet et tallsystem med 20 som grunntall. De eneste symbolene de brukte, var ● for 1, — for 5 og 〇 for 0.
Den første tabellen nedenfor viser mayatallene for 0 til 19, og den andre tabellen viser to eksempler på hvordan mayaindianerne skrev tall større enn 19.
a)Hjelpemiddelkrav: Kalkulator
Skriv mayatallet som er vist i figuren (to prikker øverst og tre prikker over én strek nederst) i vårt tiltallssystem.
b)Hjelpemiddelkrav: Kalkulator
Skriv tallet 76 slik mayaindianerne ville gjort det.
Fasit
a)
b)
, altså prikker øverst og symbolet for ( prikk over tre streker) nederst
LøsningsforslagKI-generert
a)
Mayaindianerne skriver tall i posisjoner ovenpå hverandre, der hver posisjon representerer en potens av : nederste posisjon er -plassen, neste er -plassen, og så videre.
I figuren står det prikker øverst (på -plassen) og prikker over én strek nederst (på -plassen). Ifølge symbolforklaringen betyr én strek , så nederste symbol har verdien .
Mayatallet i figuren tilsvarer altså i vårt tiltallssystem.
b)
Vi skal skrive med mayasymboler. Siden mayaindianerne bruker grunntall , deler vi opp i potenser av :
fordi og .
Dette betyr at skrives med to posisjoner:
-plassen (øverst): symbolet for , altså prikker.
-plassen (nederst): symbolet for , altså prikk over tre streker (siden ).
Sensorveiledning
Oppgaven gir til sammen 4 poeng
For å få full uttelling kreves resonnement/beregninger.
Oppgave 2-5·Innbyggertall i bygd med eksponentiell regresjon
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Tabellen nedenfor viser innbyggertallet i en liten bygd i årene fra 2005 til 2010. Hans og Grete vil ut fra tabellen lage en matematisk modell som kan brukes til å anslå innbyggertallet i bygda i årene som kommer. Hans mener de bør velge en lineær modell. Grete er ikke enig.
2005
2006
2007
2008
2009
2010
Innbyggertall
650
550
467
396
336
284
Endring fra året før
Prosentvis endring fra året før
Hans og Grete vil ut fra tabellen lage en matematisk modell som kan brukes til å anslå innbyggertallet i bygda i årene som kommer. Hans mener de bør velge en lineær modell. Grete er ikke enig.
La være antall år etter 2005, og la være innbyggertallet i bygda.
a)Hjelpemiddelkrav: Kalkulator
1)
Tegn av tabellen ovenfor i besvarelsen din. Fyll inn tallene som skal stå i resten av de hvite feltene.
2)
Bruk opplysningene i tabellen. Argumenter for at Hans og Grete ikke bør velge en lineær modell, og foreslå hvilken type modell de bør velge.
b)Hjelpemiddelkrav: Krever PC
Bruk regresjon til å finne den modellen du foreslo i a).
c)Hjelpemiddelkrav: Krever PC
1)
Hva vil innbyggertallet i bygda være i 2020 ifølge modellen du fant i b)?
2)
Hvor lang tid vil det gå før innbyggertallet er under 100 ifølge denne modellen?
Hans lager likevel en lineær modell. Han finner at .
d)Hjelpemiddelkrav: Kalkulator
Vurder om denne modellen kan brukes til å beskrive innbyggertallet i bygda i årene fram til 2020.
Fasit
a)
Se utfylt tabell. Endringen er ikke konstant, men den prosentvise endringen er tilnærmet konstant — eksponentiell modell foreslås.
b)
c)
, under innbyggere etter ca. (i løpet av 2016)
d)
— den gir negativt innbyggertall
LøsningsforslagKI-generert
a)
1) Vi regner ut endring fra året før (differansen mellom to påfølgende innbyggertall) og prosentvis endring fra året før ().
2005
2006
2007
2008
2009
2010
Innbyggertall
650
550
467
396
336
284
Endring fra året før
Prosentvis endring fra året før
2) Den absolutte endringen () minker jevnt fra år til år. En lineær modell krever at endringen fra år til år er konstant, og det er den tydeligvis ikke her — endringen blir stadig mindre i tallverdi.
Den prosentvise endringen () er derimot tilnærmet konstant, rundt hvert år. Når den prosentvise endringen er tilnærmet konstant, passer en eksponentiell modell best, siden en eksponentiell funksjon nettopp har konstant prosentvis vekst (eller nedgang) per tidsenhet.
b)
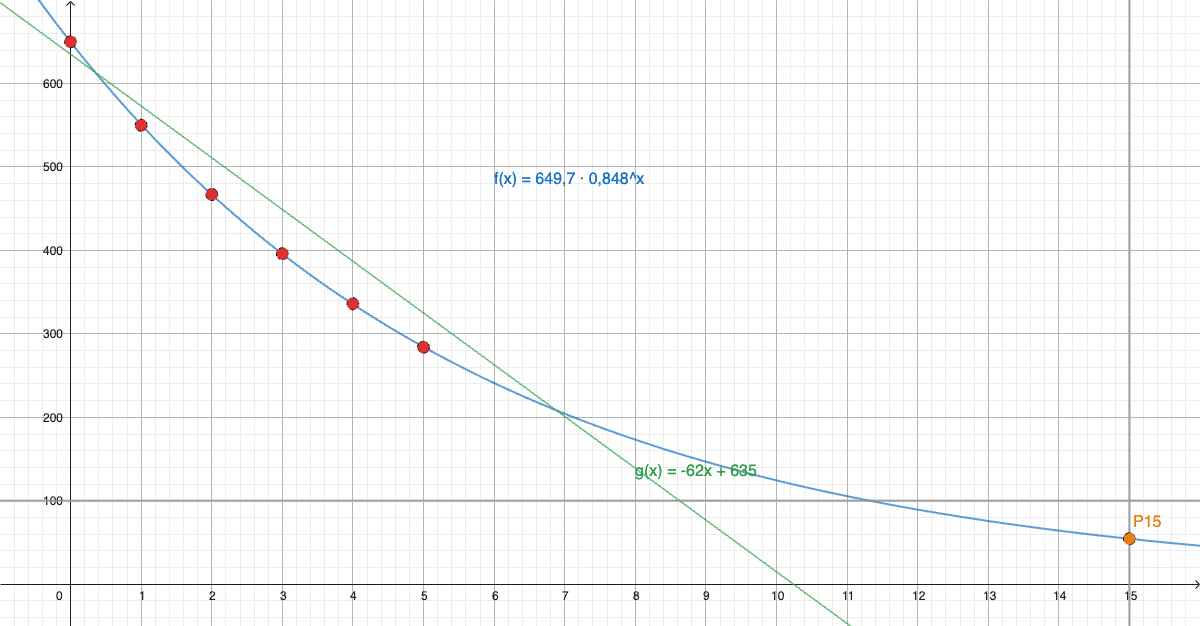
Vi legger innbyggertallene inn som punkter med antall år etter 2005, og bruker eksponentiell regresjon i GeoGebra.
Skjermbildet viser datapunktene (rødt), regresjonskurven (blått) og Hans’ lineære modell (grønt), sammen med punktet og linja som brukes i c).
c)
1) År 2020 tilsvarer . Vi setter inn i modellen (se punktet på grafen):
Ifølge modellen vil innbyggertallet i 2020 være omtrent .
2) Vi finner slik at . Fra grafen ser vi at kurven krysser linja ved
Det vil altså gå omtrent , det vil si i løpet av 2016, før innbyggertallet ifølge modellen kommer under .
d)
Vi setter (år 2020) inn i Hans’ lineære modell:
Modellen gir et negativt innbyggertall i 2020, noe som er umulig — et innbyggertall kan aldri være mindre enn . Ser vi på grafen (den grønne linja ), krysser den førsteaksen allerede ved , altså rundt 2015. Etter dette gir modellen meningsløse, negative verdier.
. Den eksponentielle modellen fra b) er en mer fornuftig beskrivelse, siden innbyggertallet der alltid forblir positivt.
Sensorveiledning
Oppgaven gir til sammen 9 poeng
b)2p2 poeng
For å få full uttelling må eleven forklare hvordan regresjonen er utført.
c)2p2 poeng
Ved grafisk løsning skal avlesning markeres tydelig. Dette gjelder også ved bruk av digitale verktøy.
Oppgave 2-6·Mopedkjørere i klasse – krysstabellsannsynlighet
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
I klasse 1B er det 12 jenter og 15 gutter. 8 av jentene og 9 av guttene kjører moped til skolen.
a)Hjelpemiddelkrav: Kalkulator
Systematiser opplysningene ovenfor i en krysstabell eller i et venndiagram.
Vi trekker tilfeldig en elev fra klassen.
b)Hjelpemiddelkrav: Kalkulator
Hva er sannsynligheten for at eleven ikke kjører moped?
Vi trekker tilfeldig en av elevene fra klassen som kjører moped.
c)Hjelpemiddelkrav: Kalkulator
Hva er sannsynligheten for at denne eleven er en gutt?
Fasit
a)
Se utfylt tabell i løsningsforslaget
b)
c)
LøsningsforslagKI-generert
a)
Klassen har jenter, hvorav kjører moped, altså jenter som ikke kjører moped. Klassen har gutter, hvorav kjører moped, altså gutter som ikke kjører moped.
Jente
Gutt
Totalt
Kjører moped
8
9
17
Kjører ikke moped
4
6
10
Totalt
12
15
27
b)
Klassen har totalt elever, og av dem kjører ikke moped:
c)
Vi vet at den trukne eleven kjører moped, og skal finne sannsynligheten for at eleven er gutt. Av de elevene som kjører moped, er gutter:
Oppgave 2-7·Kaffemaskiner med ulik pris og driftskostnad
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
I denne oppgaven skal vi se på hvor mye det koster å lage en kopp kaffe med tre ulike typer kaffemaskiner.
Maskin 1
Maskin 2
Maskin 3
Pris
1500 kroner
700 kroner
9000 kroner
Driftsutgifter per kopp
kroner
kroner
kroner
a)Hjelpemiddelkrav: Kalkulator
Hvor mange kopper må du lage for at det skal lønne seg å kjøpe henholdsvis maskin 1, maskin 2 og maskin 3?
Anta at en familie i gjennomsnitt lager seks kopper kaffe per dag. Far påstår at det vil lønne seg å kjøpe den dyreste maskinen hvis denne varer i mer enn tre år.
b)Hjelpemiddelkrav: Kalkulator
Undersøk om fars påstand stemmer.
Fasit
a)
b)
LøsningsforslagKI-generert
a)
Vi setter opp en totalkostnadsfunksjon for hver maskin, der er antall kopper kaffe som lages. Totalkostnaden er innkjøpspris pluss driftsutgifter per kopp ganget med antall kopper.
For er maskin 2 billigst siden den har lavest innkjøpspris. Maskin 2 har imidlertid høyest driftsutgift per kopp, så etter hvert som øker vil de andre maskinene ta igjen maskin 2. Vi finner ut når maskin 1 blir billigere enn maskin 2, ved å sette :
Videre finner vi når maskin 3 blir billigere enn maskin 1, ved å sette :
(Vi kan også kontrollere med , som gir . Siden dette er mindre enn , betyr det at maskin 1 allerede er billigere enn maskin 2 på det tidspunktet, så maskin 2 er aldri billigst etter kopper.)
Konklusjon:
For færre enn ca. kopper lønner maskin 2 seg best (lavest totalkostnad).
Mellom ca. og kopper lønner maskin 1 seg best.
For flere enn ca. kopper lønner maskin 3 seg best.
b)
Familien lager i gjennomsnitt kopper kaffe per dag. Over år (vi regner dager) blir totalt antall kopper
Vi setter dette inn i de tre kostnadsfunksjonene:
Etter år er maskin 3 billigst av de tre, med god margin. Dette stemmer også med svaret i a): breakevenpunktet der maskin 3 blir billigst er ved ca. kopper, noe som med kopper per dag tilsvarer
Maskin 3 lønner seg altså allerede etter ca. år, og dermed helt klart etter år. Fars påstand stemmer.
Sensorveiledning
Oppgaven gir til sammen 4 poeng
Ved grafisk løsning skal avlesning markeres tydelig. Dette gjelder også ved bruk av digitale verktøy.
Oppgave 2-8·Sentralmål og standardavvik ved dobling av tallmengde
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
a)Hjelpemiddelkrav: Kalkulator
Finn median, gjennomsnitt og standardavvik for tallmengden:
Vi dobler alle tallene i tallmengden og får:
b)Hjelpemiddelkrav: Kalkulator
Finn median, gjennomsnitt og standardavvik for denne tallmengden. Sammenlikn med resultatene fra a) og kommenter.
Berit får en idé og setter opp tabellen nedenfor.
Tallmengde 1 (15 tall)
2
5
21
15
17
5
9
19
10
14
7
3
2
11
13
Tallmengde 2 (de 15 tallene doblet)
4
10
42
30
34
10
18
38
20
28
14
6
4
22
26
Tallmengde 3 (de 15 tallene tredoblet)
6
15
63
45
51
15
27
57
30
42
21
9
6
33
39
Tallmengde 4 (de 15 tallene firedoblet)
8
20
84
60
68
20
36
76
40
56
28
12
8
44
52
Hun beregner median, gjennomsnitt og standardavvik for hver av tallmengdene og påstår at hun har funnet regler som sier noe om hvordan medianen, gjennomsnittet og standardavviket endrer seg når tallene i en tallmengde dobles, tredobles, firedobles osv.
c)Hjelpemiddelkrav: Kalkulator
Formuler disse reglene, og gi en begrunnelse for at de er riktige.
Fasit
a)
b)
— nøyaktig dobbelt så store som i a)
c)
Ved multiplikasjon av alle tall med en konstant : median, gjennomsnitt og standardavvik multipliseres alle med .
LøsningsforslagKI-generert
a)
Vi sorterer tallmengden:
Med (oddetall) er medianen den midterste (8.) verdien:
Standardavviket regnes med den empiriske formelen (deling på , som i GeoGebra/Excel STDAV):
Svar:
b)
Den doblede tallmengden, sortert:
Svar:
Sammenligning: Alle tre verdiene er nøyaktig dobbelt så store som i a): , og . Når vi dobler alle tallene i datamaterialet, dobles altså både medianen, gjennomsnittet og standardavviket.
c)
Regelen: Dersom alle tallene i en tallmengde multipliseres med en (positiv) konstant , slik at vi får , så gjelder:
Dette stemmer med tabellen til Berit: ved dobling () blir alle tre målene doblet, ved tredobling () blir de tredoblet, og ved firedobling () blir de firedoblet.
Begrunnelse for gjennomsnitt:
Begrunnelse for median: Multiplikasjon med en positiv konstant endrer ikke rekkefølgen på tallene – er , så er også . Sorterer vi -verdiene, havner de derfor i akkurat samme rekkefølge som -verdiene, bare multiplisert med . Den midterste verdien (eller gjennomsnittet av de to midterste) blir da ganger så stor som i den opprinnelige tallmengden, altså .
Begrunnelse for standardavvik:
Siden , følger det at
Alle avvikene fra gjennomsnittet skaleres altså med , og siden standardavviket måler nettopp spredningen (avvikene) rundt gjennomsnittet, skaleres også standardavviket med .