Eksamensoppgavene er utgitt av Utdanningsdirektoratet. Første nedlasting kjører en bot-sjekk i nettleseren (Vercel BotID) — mer i personvernerklæringen.
Del 1uten hjelpemidler · 1 time · 4 oppgaver
Oppgave 1-1·Median eller gjennomsnitt for Maias boklesing
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
I sommerferien liker Maia å lese bøker. Nedenfor ser du hvor mange sider hun leste hver av de 10 første dagene i ferien.
20 15 15 25 20 15 25 100 25 20
a)
Bestem medianen og gjennomsnittet for datamaterialet.
b)
Hvilket av de to sentralmålene mener du best beskriver datamaterialet?
Husk å begrunne svaret ditt.
Fasit
a)
,
b)
Medianen beskriver datamaterialet best
LøsningsforslagKI-generert
a)
Vi sorterer tallene fra minst til størst:
Det er tall, altså et partall. Da er medianen gjennomsnittet av de to midterste tallene, som er tall nummer og i den sorterte rekken:
Gjennomsnittet finner vi ved å summere alle tallene og dele på antallet:
Medianen er , og gjennomsnittet er .
b)
Én av dagene leste Maia hele sider, mens hun de andre dagene leste mellom og sider. Denne ene ekstremverdien drar gjennomsnittet kraftig opp, slik at gjennomsnittet på sider gir et feilaktig inntrykk av en “typisk” lesedag for Maia — de fleste dagene leste hun langt mindre enn dette.
Medianen på sider blir ikke påvirket av ekstremverdien på samme måte, siden den bare ser på hvilket tall som ligger i midten av datamaterialet.
Medianen beskriver derfor datamaterialet best, fordi den ikke lar seg påvirke av enkeltdager med uvanlig høyt eller lavt lesetall.
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Tabellen nedenfor viser konsumprisindeksen (KPI) for årene 2015—2021.
År
2015
2016
2017
2018
2019
2020
2021
KPI
100
103,6
105,5
108,4
110,8
112,2
116,1
I 2015 hadde Anna en nominell lønn på kroner.
I 2019 hadde hun en nominell lønn på kroner.
I hvilket av disse to årene hadde hun størst kjøpekraft?
Fasit
LøsningsforslagKI-generert
For å sammenligne kjøpekraften i to forskjellige år må vi regne om den nominelle (faktiske) lønnen til det vi kaller reallønn, altså hva lønnen er verdt målt i faste priser. Vi bruker som referanseår, siden KPI det året. Reallønnen finner vi med formelen
Reallønn i 2015:
I 2015 er KPI , så reallønnen er lik den nominelle lønnen:
Reallønn i 2019:
I 2019 er KPI , og den nominelle lønnen er :
Sammenligning:
Reallønnen (kjøpekraften) i 2015 var , mens reallønnen i 2019 var omtrent , altså litt lavere. Selv om Anna hadde en høyere nominell lønn i 2019, hadde hun dermed noe mindre kjøpekraft det året, fordi prisene (KPI) hadde steget mer enn lønnen hennes.
Oppgave 1-3·Python-program med if-test for a, b og c
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
# Velger verdier for a, b og ca = 4b = 5c = 3if a ** 2 + b ** 2 == c ** 2 or a ** 2 + c ** 2 == b ** 2 or b ** 2 + c ** 2 == a ** 2: print(" ")
Lars har laget programmet ovenfor.
Hva kan han bruke programmet til?
Foreslå en passende tekst som kan skrives i linje 11.
Fasit
Programmet sjekker om , og kan være sidelengdene i en rettvinklet trekant (Pytagoras’ setning). Forslag til linje 11:
LøsningsforslagKI-generert
Vi sporer gjennom programmet linje for linje.
I linje 3–5 blir variablene satt til , og .
I linje 9 sjekker if-testen om én av de tre sammenhengene som gjelder for en rettvinklet trekant (Pytagoras’ setning) er oppfylt, altså om kvadratet av én side er lik summen av kvadratene til de to andre sidene. Vi setter inn tallene i hvert av de tre leddene:
Her er , så dette leddet er usant.
Her er , så dette leddet er sant.
Siden if-testen bruker or, holder det at ett av leddene er sant for at hele betingelsen skal bli sann. Betingelsen i linje 9 blir dermed sann, og programmet går inn i if-blokken og kjører print-setningen i linje 11.
Programmet sjekker altså, for tre gitte tall , og , om de kan være sidelengdene i en rettvinklet trekant. Med , og stemmer dette, siden , og er sidene i en velkjent rettvinklet trekant (den minste pytagoreiske tripletten).
En passende tekst i linje 11 må derfor fortelle brukeren at de tre tallene faktisk danner en rettvinklet trekant, for eksempel:
Oppgave 1-4·Solveig løser ulikhet og likning grafisk
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
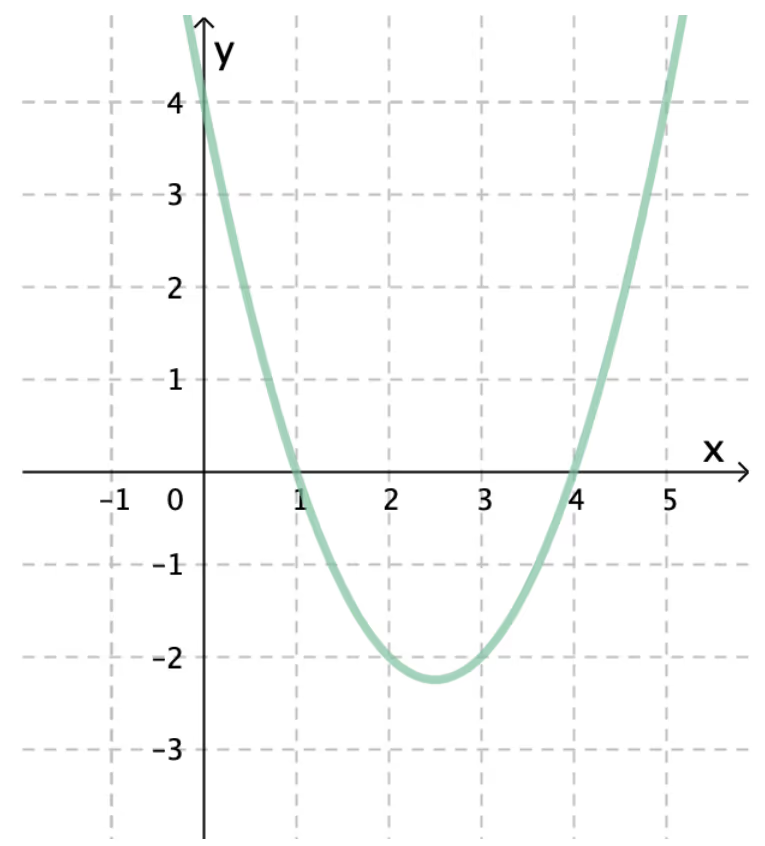
I koordinatsystemet ovenfor ser du grafen til funksjonen gitt ved
Solveig har fått de to oppgavene nedenfor.
Løs ulikheten
Løs likningen
Vis Solveig hvordan hun kan løse oppgavene ved å bruke den grafiske framstillingen.
Fasit
LøsningsforslagKI-generert
1) Ulikheten
Vi flytter alt over på venstre side, slik at ulikheten sammenlignes med :
Å løse ulikheten er dermed det samme som å finne ut hvilke -verdier som gjør at grafen til ligger under -aksen. Av den oppgitte grafen ser vi at skjærer -aksen i og , og at grafen ligger under -aksen mellom disse to nullpunktene (parabelen vender grenene oppover, og er negativ mellom røttene).
Løsningen av ulikheten er .
2) Likningen
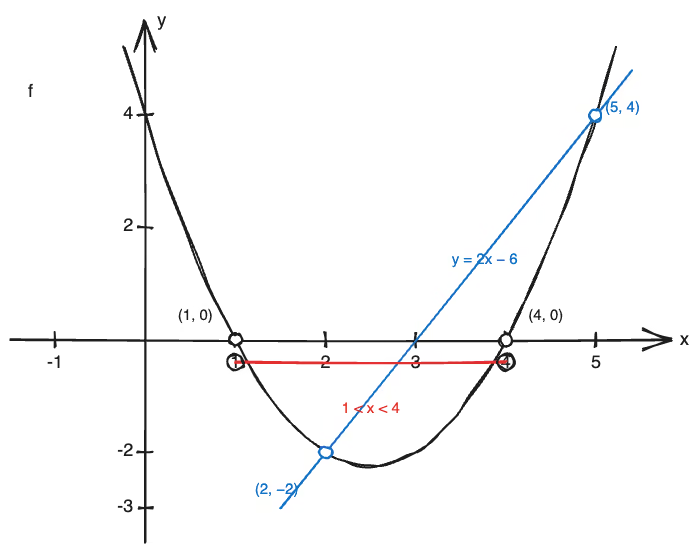
Her er venstre side lik , mens høyre side er uttrykket for en rett linje, . Å løse likningen grafisk vil si å tegne linjen inn i samme koordinatsystem som , og lese av -koordinatene til skjæringspunktene mellom grafen og linjen.
Linjen har stigningstall og skjærer -aksen i . Vi tegner den inn sammen med grafen til :
Av skissen ser vi at grafen til og linjen skjærer hverandre i punktene og .
Løsningen av likningen er , altså -koordinatene til skjæringspunktene.
Oppgave 2-1·Prisforskjell mellom to kaffetyper 2P H22
Hjelpemiddelkrav: Kalkulator
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
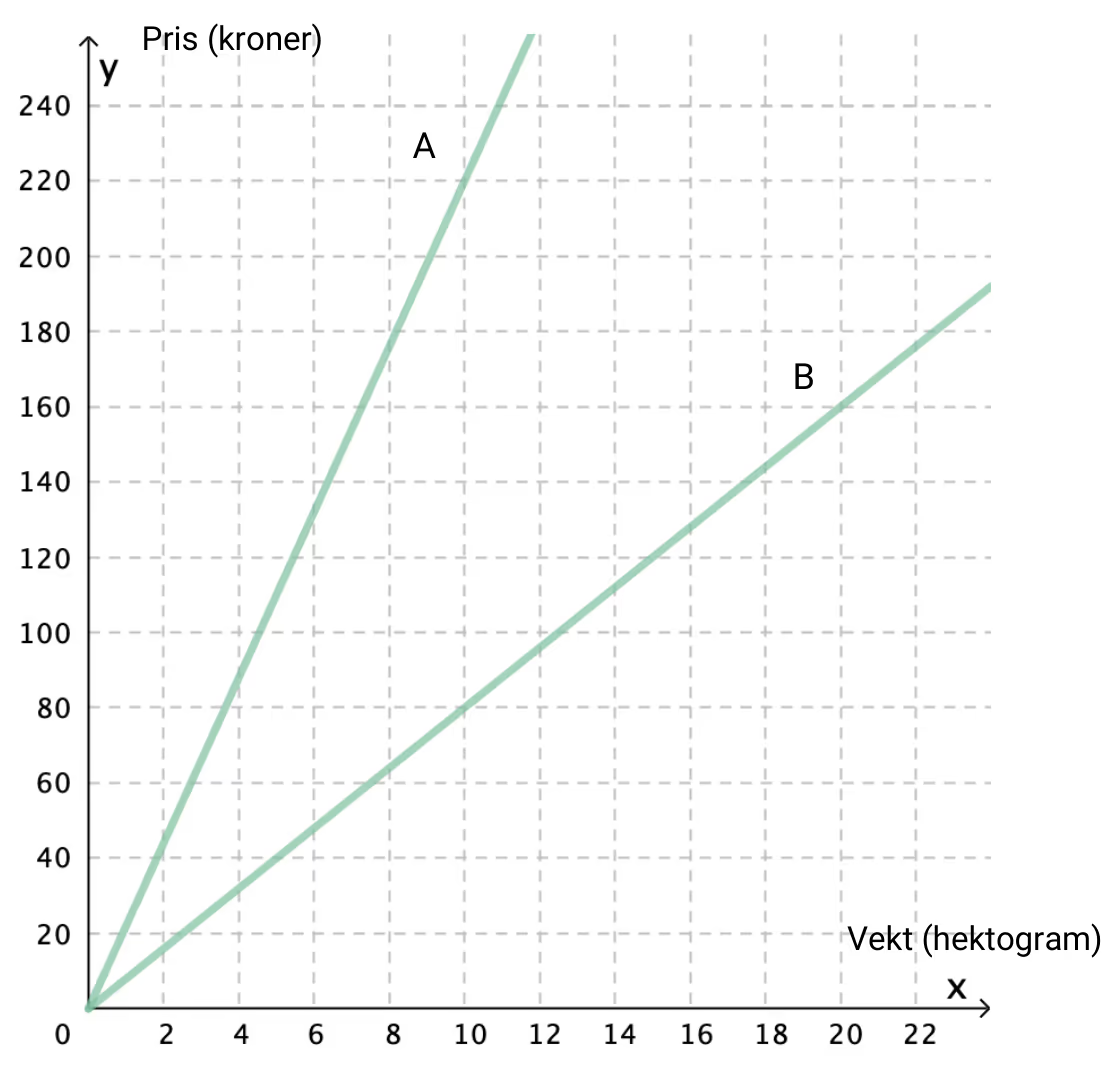
Den grafiske framstillingen ovenfor viser sammenhengen mellom vekt og pris for to ulike typer kaffe, type A og type B.
Hvor stor er prisforskjellen per hektogram?
Fasit
LøsningsforslagKI-generert
For en proporsjonal sammenheng er stigningstallet lik prisen per hektogram. Vi finner stigningstallet til hver linje ved å lese av et punkt på linja der linja krysser en gitterlinje.
For linje leser vi av punktet :
For linje leser vi av punktet :
Prisforskjellen per hektogram blir dermed
Kaffetype A koster altså kroner mer per hektogram enn kaffetype B.
Oppgave 2-4·Seks rektangler med samme areal og diagramvalg
Hjelpemiddelkrav: For hånd
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Jens har seks rektangler. Alle rektanglene har samme areal.
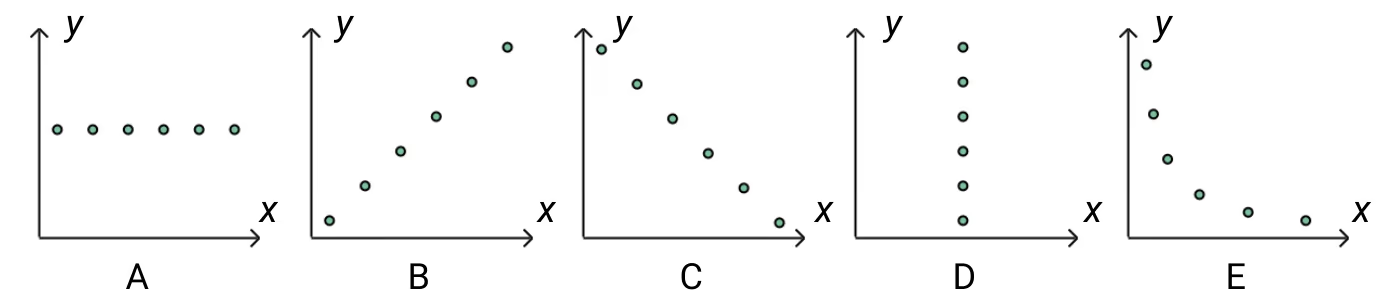
Hvilket av diagrammene nedenfor viser sammenhengen mellom lengden og bredden i hvert rektangel?
Husk å begrunne svaret ditt.
Fasit
Diagram E.
LøsningsforslagKI-generert
For alle de seks rektanglene er arealet det samme. Kaller vi dette felles arealet for , gjelder for hvert rektangel
Bredden er altså omvendt proporsjonal med lengden : øker , må minke slik at produktet forblir konstant.
For å se hvordan denne sammenhengen ser ut, kan vi tenke oss et areal, for eksempel , og regne ut noen tilhørende verdipar:
1
2
3
4
6
8
24
12
8
6
4
3
Vi ser at avtar når øker, men ikke jevnt: for små -verdier faller raskt, mens for store -verdier flater kurven ut (fra til synker bare fra til ). Dette gir en synkende, buet kurve, ikke en rett linje.
Dette utelukker de andre diagrammene:
A (vannrett rekke) og D (loddrett rekke) betyr at (eller ) er konstant uansett (eller ) — det stemmer ikke, siden begge sidene i rektanglene varierer.
B (stigende rett linje) ville betydd at øker når øker — da ville arealet blitt stadig større, ikke konstant.
C (synkende rett linje) er også feil, fordi en rett linje svarer til en lineær sammenheng (), ikke en omvendt proporsjonal sammenheng. Med en rett linje ville produktet variert langs linjen, ikke holdt seg konstant.
Bare diagram E, med en synkende kurve som flater ut, kan vise seks punkter som alle ligger på en hyperbel med konstant areal.
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
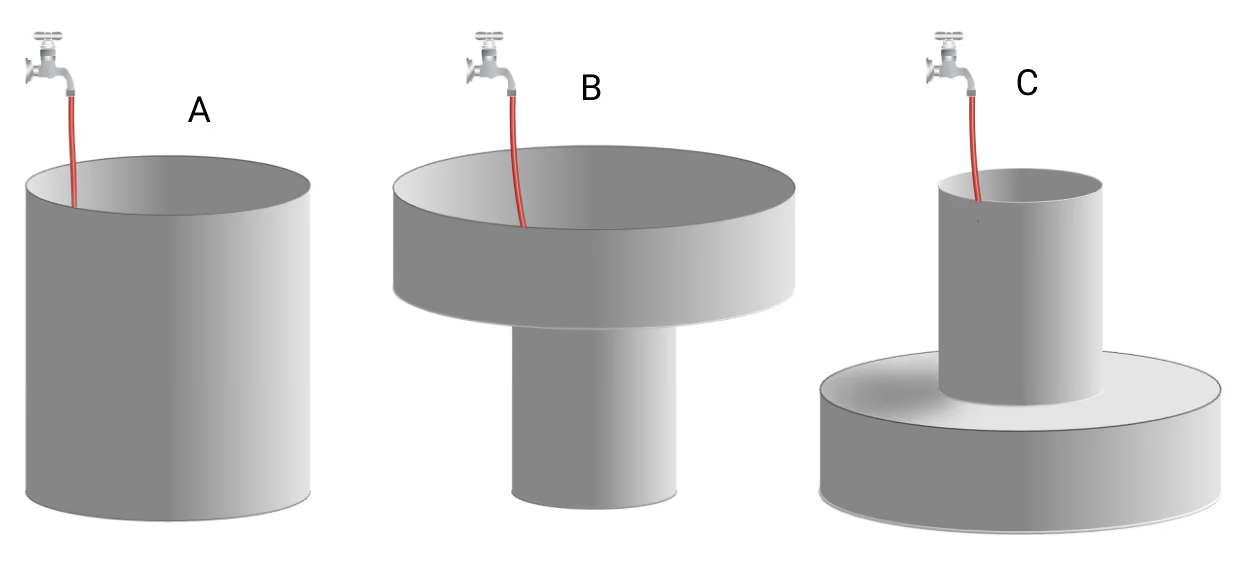
Per skal fylle de tre beholderne ovenfor med vann. Vannet renner inn i hver beholder med samme konstante hastighet.
a)Hjelpemiddelkrav: For hånd
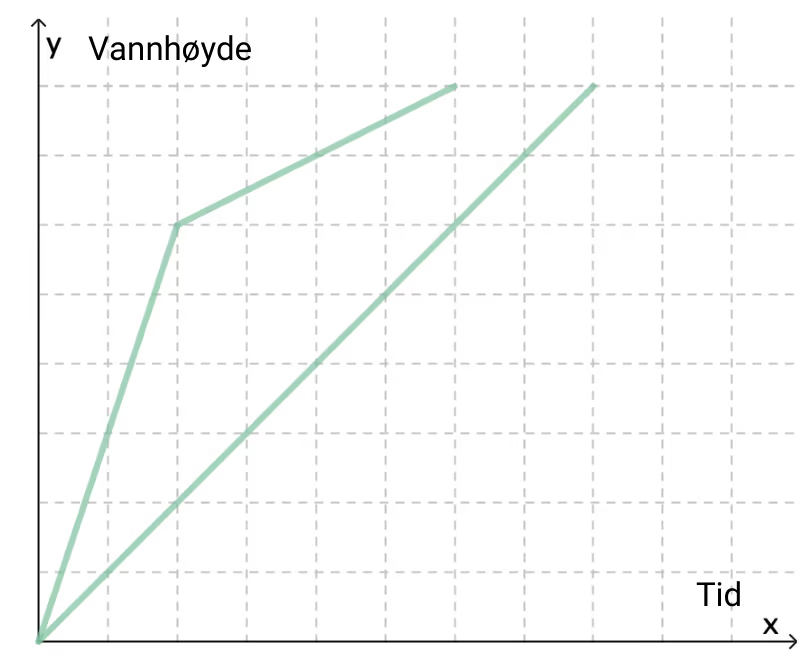
Grafene nedenfor viser sammenhengen mellom tid og vannhøyde for to av beholderne. Hvilke to?
Husk å begrunne svaret ditt.
b)Hjelpemiddelkrav: For hånd
Tegn av koordinatsystemet ovenfor med de to grafene.
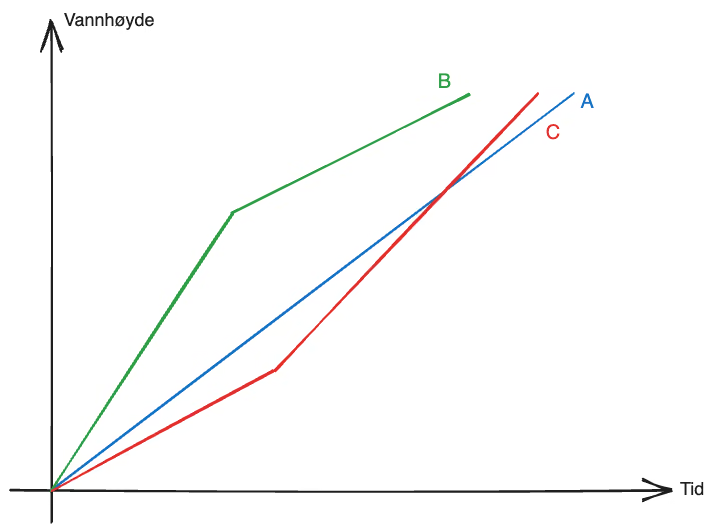
Tegn også inn grafen som viser sammenhengen mellom tid og vannhøyde når den tredje beholderen blir fylt.
Forklar hvordan du tenker når du tegner den siste grafen.
Fasit
a)
b)
Se skisse i løsningsforslaget
LøsningsforslagKI-generert
a)
Farten vannet stiger med, avhenger av hvor bredt tverrsnittet til beholderen er der vannet står. Jo smalere tverrsnitt, jo raskere stiger vannhøyden, siden det skal mindre vann til for å heve nivået med én centimeter. Jo bredere tverrsnitt, jo saktere stiger vannhøyden.
Beholder A er en sylinder med samme bredde hele veien opp. Da stiger vannet like fort hele tiden, og grafen blir en rett linje fra origo.
Beholder B er smal nederst og vid øverst. Vannet stiger derfor raskt (bratt graf) mens den smale delen fylles, og deretter saktere (slakere graf) når den vide delen på toppen fylles.
Beholder C er vid nederst og smal øverst. Vannet stiger derfor saktere (slak graf) mens den vide delen fylles, og deretter raskere (bratt graf) når den smale delen på toppen fylles.
Den ene grafen som er gitt, er en rett linje gjennom origo — det passer med beholder A. Den andre grafen stiger bratt først og flater deretter ut — det passer med beholder B, siden den fylles fort i den smale bunnen og sakte i den vide toppen.
b)
Grafen til beholder C skal ha motsatt form av grafen til beholder B: den skal stige sakte (slakt) i starten, mens den brede bunnen av C fylles, og deretter raskt (bratt) mot slutten, når den smale toppen av C fylles.
Forklaring: Siden C har en vid (bred) del nederst, trengs det mye vann for å heve vannstanden der, så grafen starter med et lite stigningstall (slak). Når vannet når den smale delen øverst i C, skal det mye mindre vann til per centimeter høyde, så grafen blir brattere mot slutten.
Oppgave 2-6·Misvisende linjediagram for e-poster 2P H22
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
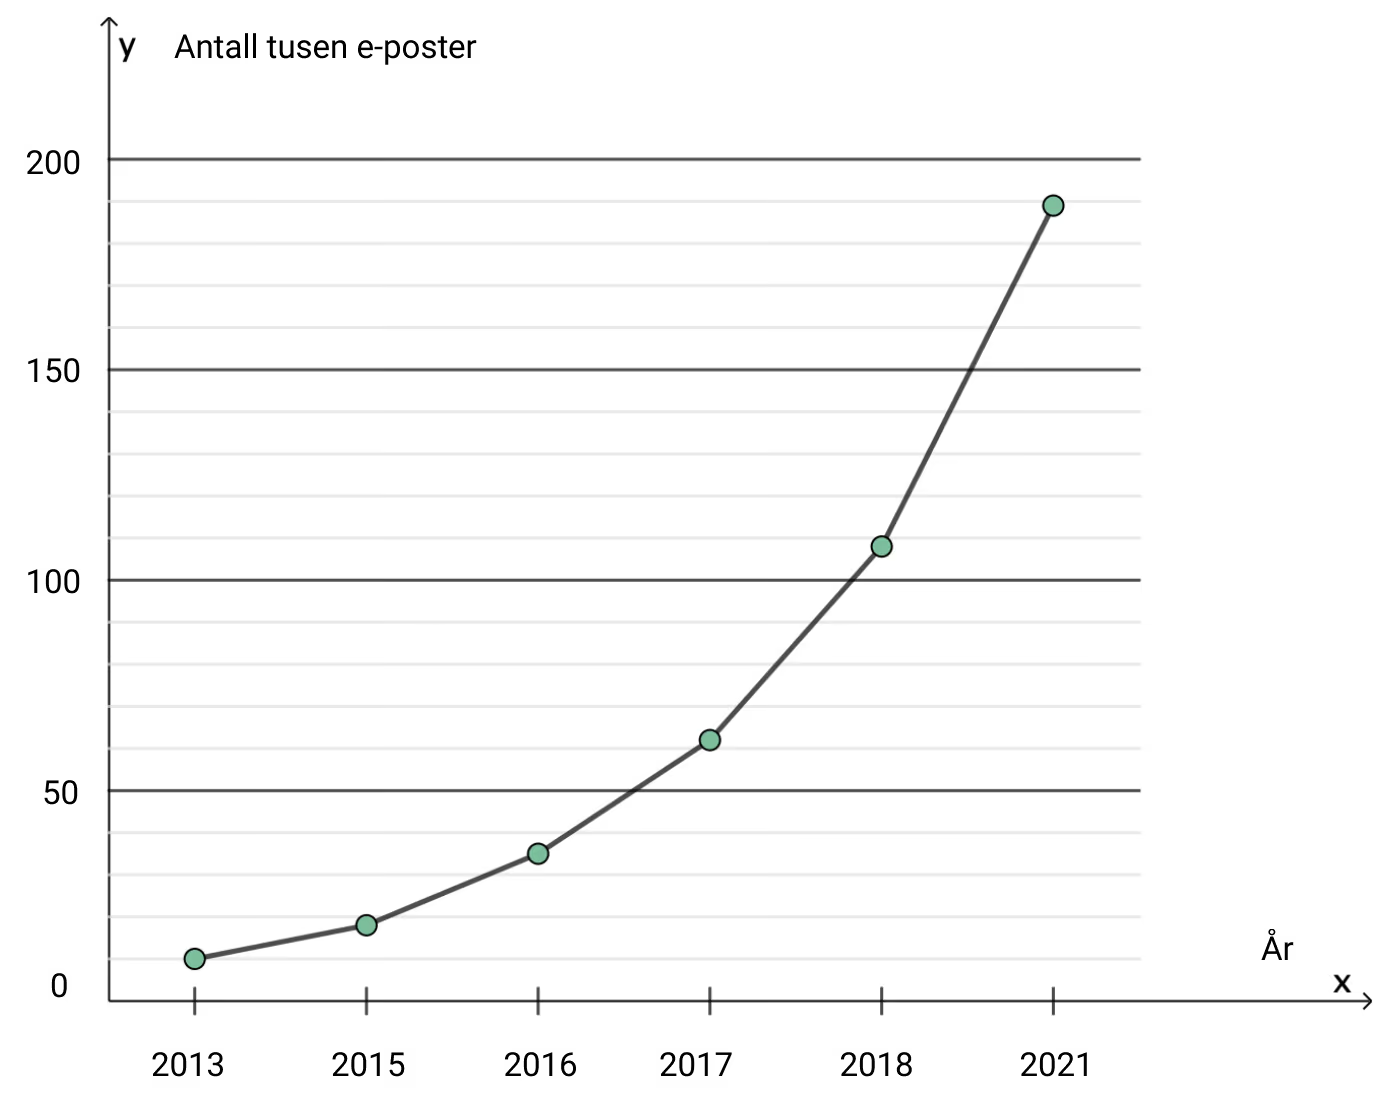
Jens har laget et linjediagram som skal vise hvor mange e-poster som i gjennomsnitt ble sendt hver dag i et firma i årene 2013–2021. Se ovenfor.
a)Hjelpemiddelkrav: For hånd
Hvorfor er diagrammet misvisende?
b)Hjelpemiddelkrav: For hånd
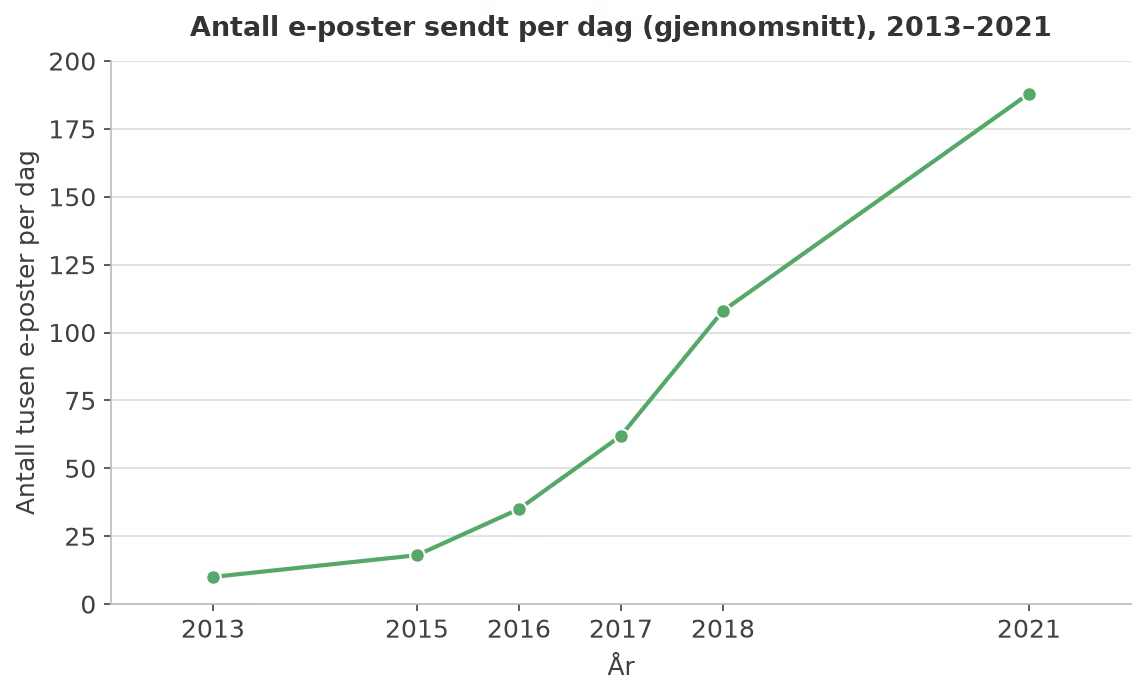
Lag et linjediagram du mener er mindre misvisende.
Begrunn hvorfor du mener diagrammet ditt illustrerer de gitte opplysningene på en bedre måte.
Jens påstår at antallet e-poster som i gjennomsnitt ble sendt hver dag, økte mest fra 2017 til 2018.
c)Hjelpemiddelkrav: Kalkulator
Vurder om denne påstanden kan være riktig.
Fasit
a)
Tidsaksen har lik avstand mellom årstallene, selv om tidsrommene mellom dem ikke er like lange.
b)
c)
LøsningsforslagKI-generert
a)
I diagrammet står årstallene og med like stor avstand mellom seg langs førsteaksen. I virkeligheten er ikke tidsrommene mellom disse årstallene like lange:
Intervall
Antall år
2013–2015
2
2015–2016
1
2016–2017
1
2017–2018
1
2018–2021
3
Fordi aksen ikke er en riktig tallakse for tid, ser det ut som om e-postmengden vokser i et jevnt tempo fra punkt til punkt. I virkeligheten er for eksempel den siste økningen (fra 2018 til 2021) strukket ut over tre år, men den er tegnet med samme bredde som overgangene som bare gjelder ett år. Diagrammet gir dermed et misvisende inntrykk av hvor raskt antallet e-poster faktisk økte i de ulike periodene.
b)
Vi lager et nytt linjediagram der førsteaksen er en riktig tallakse for årstall, slik at avstanden mellom to årstall på aksen er proporsjonal med hvor mange år som faktisk skiller dem. Andreaksen starter fortsatt på , slik som i det opprinnelige diagrammet.
Nå ser vi at linjestykket fra til strekker seg over en mye bredere del av aksen enn de andre linjestykkene, siden det dekker tre år. Diagrammet gir dermed et riktigere bilde av hvor bratt økningen faktisk var i de ulike periodene.
c)
Vi leser av (omtrent) følgende verdier fra diagrammet, i tusen e-poster per dag:
År
2013
2015
2016
2017
2018
2021
Antall (tusen)
Vi regner ut økningen i antall (differansen) mellom hvert par av nabotall, og hvor mange år økningen er fordelt på:
Periode
Økning (tusen)
Antall år
Økning per år
2013–2015
2015–2016
2016–2017
2017–2018
2018–2021
Den årlige økningen fra 2017 til 2018 er tusen e-poster, som er klart mer enn i alle de andre periodene — også mer enn gjennomsnittet på ca. tusen per år for perioden 2018–2021 (som samlet økte med tusen, men fordelt på tre år). Målt i antall stemmer altså Jens’ påstand: ingen annen ettårsperiode i datamaterialet har en like stor økning som 2017–2018.
Det er verdt å merke seg at vi ikke har egne tall for 2019 og 2020, men siden gjennomsnittet for hele perioden 2018–2021 er godt under tusen per år, støtter datagrunnlaget vi har påstanden.
Absolutt økning er ikke det samme som prosentvis økning. Regner vi i stedet ut hvor mange prosent antallet økte med i hver periode,
ser vi at den prosentvis største økningen var fra 2015 til 2016 (), mens økningen fra 2017 til 2018 bare var på . Så om Jens hadde ment «økte mest» i prosent, ville påstanden vært feil — men målt i faktisk antall e-poster stemmer den.
Oppgave 2-7·Blomsterbed formet som to formlike trekanter
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
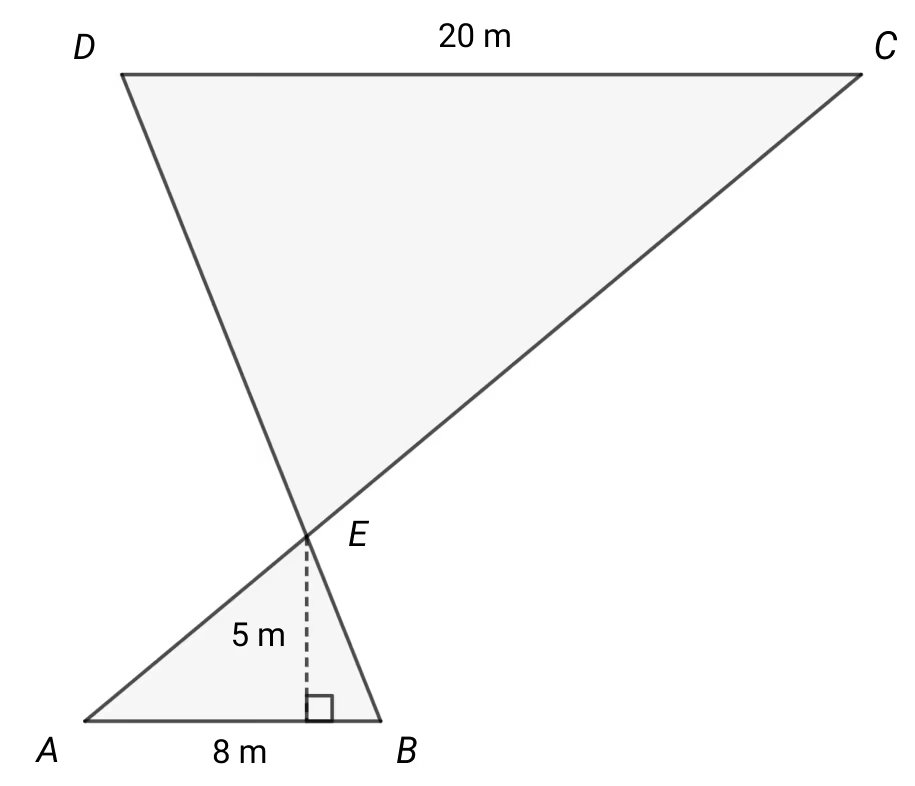
Edvard er anleggsgartner og skal lage et blomsterbed med form som vist på figuren ovenfor.
Avstanden fra til er 8 meter, avstanden fra til er 20 meter, er parallell med , og høyden fra ned på er 5 meter.
Edvard påstår at og er formlike.
a)Hjelpemiddelkrav: For hånd
Argumenter for at Edvards påstand er riktig.
b)Hjelpemiddelkrav: Kalkulator
Vis hvordan du kan bruke formlikhet til å bestemme hvor stort areal blomsterbedet vil få.
Fasit
a)
De to trekantene er formlike fordi de har to par like vinkler (AA).
b)
LøsningsforslagKI-generert
a)
Siden trekantene bare møtes i punktet , ligger , og på én rett linje, og , og på en annen rett linje. Det betyr at
fordi dette er toppvinkler (vertikalvinkler) — vinkler som dannes når to rette linjer krysser hverandre, er alltid like store.
I tillegg er parallell med . Linjen gjennom , og er da en transversal som krysser de to parallelle linjene og . Det gir
fordi dette er samsvarende/vekselvinkler ved parallelle linjer.
Trekantene og har dermed to par like vinkler. Når to trekanter har to par like vinkler, er det tredje vinkelparet også likt (vinkelsummen i en trekant er ). Dermed er og formlike (AA-kriteriet), og Edvards påstand stemmer.
b)
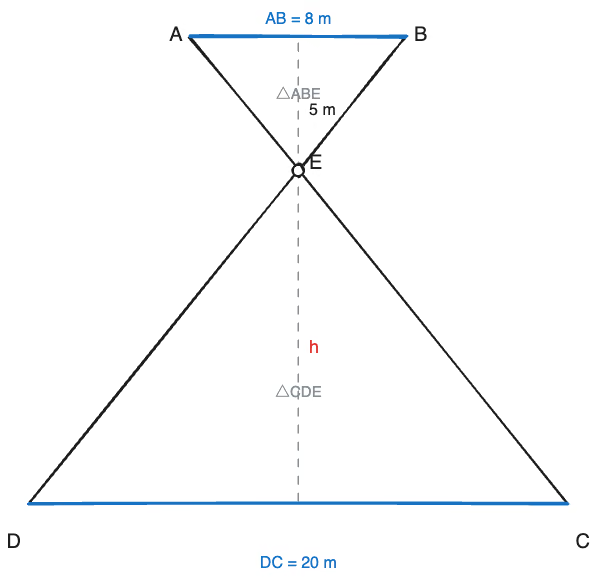
Fordi trekantene er formlike, er forholdet mellom tilsvarende sider (og tilsvarende høyder) det samme i begge trekanter. Tilsvarende sider er og , siden disse er de parallelle sidene som ligger midt imot det felles hjørnet .
Forholdet mellom sidene er
Høyden fra ned på er oppgitt til . Siden trekantene er formlike med forholdstall , er også høyden fra ned på (kall den ) ganger så stor:
Nå kan vi regne ut arealet til hver av de to trekantene, og legge dem sammen:
Oppgave 2-8·Statistikk for hytter i norske regioner 2P H22
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Region
Antall hytter/fritidsbygg
1
Ringsaker
7286
2
Trysil
6926
3
Hol
5832
4
Vinje
5713
5
Sigdal
5050
6
Larvik
4890
7
Nord-Aurdal
4806
8
Orkland
4575
9
Fredrikstad
4403
10
Ringebu
4369
11
Hvaler
4332
12
Sirdal
4221
13
Oppdal
4142
14
Nore og Uvdal
4095
15
Asker
4004
Ovenfor ser du hvor i Norge det er flest hytter/fritidsbygg i 2022.
a)Hjelpemiddelkrav: Kalkulator
Bestem gjennomsnittet, medianen og standardavviket for datamaterialet.
Ingrid vil regne ut medianen, gjennomsnittet og standardavviket for regionene som kommer på de neste 15 plassene i denne oversikten. Hun vil sammenlikne svarene hun får, med resultatene fra oppgave a).
Ingrid lurer på
om hun vil få et høyere eller lavere gjennomsnitt
om det vil være større forskjell mellom median og gjennomsnitt
om hun vil få et høyere eller lavere standardavvik
b)Hjelpemiddelkrav: For hånd
Vurder om det er mulig å si noe om det Ingrid lurer på.
Husk å begrunne svarene dine.
Fasit
a)
Gjennomsnitt , median , standardavvik
b)
Vi kan begrunne noen antagelser, men ikke være sikre uten å regne ut de faktiske tallene
LøsningsforslagKI-generert
a)
Datamaterialet består av verdier (antall hytter i de 15 regionene):
Gjennomsnitt. Vi summerer alle verdiene og deler på antallet:
Median. Siden er oddetall, er medianen den midterste verdien når tallene sorteres. Sortert (stigende) er den midterste verdien (nummer 8 av 15) lik — som også er verdien til Orkland, som allerede står på 8. plass i den opprinnelige (synkende) tabellen:
Standardavvik. Vi taster inn alle verdiene i ett-variabel statistikk-modus på kalkulatoren og leser av standardavviket , som bygger på formelen
der vi setter inn de samme 15 verdiene og . Dette gir
Datamaterialet for de 15 regionene med flest hytter har altså et gjennomsnitt på omtrent hytter, en median på hytter og et standardavvik på omtrent hytter.
b)
Vi har ikke de faktiske tallene for regionene på plass 16–30, så vi kan ikke regne ut de eksakte verdiene Ingrid er ute etter. Men vi kan begrunne noen rimelige antagelser ut fra hvordan tabellen er bygget opp (den er sortert fra størst til minst antall hytter):
1) Gjennomsnittet. Siden listen er sortert synkende, vil alle regionene på plass 16–30 ha færre hytter enn den minste verdien i vårt datasett (). Da må også gjennomsnittet av de neste 15 regionene bli lavere enn .
2) Forskjellen mellom median og gjennomsnitt. I vårt datasett er gjennomsnittet () tydelig høyere enn medianen (). Det skyldes at datasettet er høyreskjevt: Ringsaker og Trysil har mye høyere verdier ( og ) enn resten, og disse ekstremverdiene trekker gjennomsnittet opp. Lenger ned i rangeringen er det grunn til å tro at verdiene ligger tettere sammen (mindre store “hopp” mellom naboplassene), slik at datasettet blir mindre skjevt. Det taler for at forskjellen mellom median og gjennomsnitt trolig blir mindre for de neste 15 regionene — men vi kan ikke være sikre, siden vi ikke vet om det finnes nye ekstremverdier i dette området av listen også.
3) Standardavviket. Av samme grunn er det rimelig å anta at spredningen i tallmaterialet blir mindre lenger ned i en rangert liste som denne, siden forskjellene mellom naboplassene gjerne blir mindre jo lenger ute i “halen” av fordelingen man kommer. Det trekker i retning av at standardavviket trolig blir lavere enn .
Konklusjonen er at vi kan gi begrunnede antagelser om retningen på alle tre størrelsene (lavere gjennomsnitt, sannsynligvis mindre forskjell mellom median og gjennomsnitt, og sannsynligvis lavere standardavvik), men vi kan for regionene på plass 16–30.
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Jonas og Margrete arbeider med et problem. De skal prøve å finne ut hvor lang tid det vil ta før et beløp blir doblet på en sparekonto. Banken tilbyr en fast rentesats på per år.
Jonas vil bruke et regneark. Margrete vil tegne en graf.
a)Hjelpemiddelkrav: Krever PC
Hjelp Jonas og Margrete. Vis hvordan du kan bruke et regneark, og hvordan du kan lage en grafisk framstilling, som gir dem svar på problemet.
På en nettside har Jonas og Margrete funnet teksten nedenfor.
b)Hjelpemiddelkrav: Krever PC
Lag en oversikt som viser hvor godt denne regelen stemmer for ulike rentesatser.
Margrete påstår at det kan være lurere å bruke 70 i stedet for 72.
c)Hjelpemiddelkrav: Krever PC
Undersøk om dette kan være riktig.
Fasit
a)
Doblingstiden ved rente er .
b)
Se tabellen i løsningsforslaget: -regelen stemmer best for rentesatser rundt –, og bommer mer jo lenger unna dette renta er.
c)
Margrete har rett: , blant annet for de banken i denne oppgaven tilbyr.
LøsningsforslagKI-generert
a)
Vi antar at Jonas og Margrete setter inn et valgfritt beløp, for eksempel , på kontoen, og at pengene står urørt mens de vokser med en fast årlig rente på . Vekstfaktoren blir da
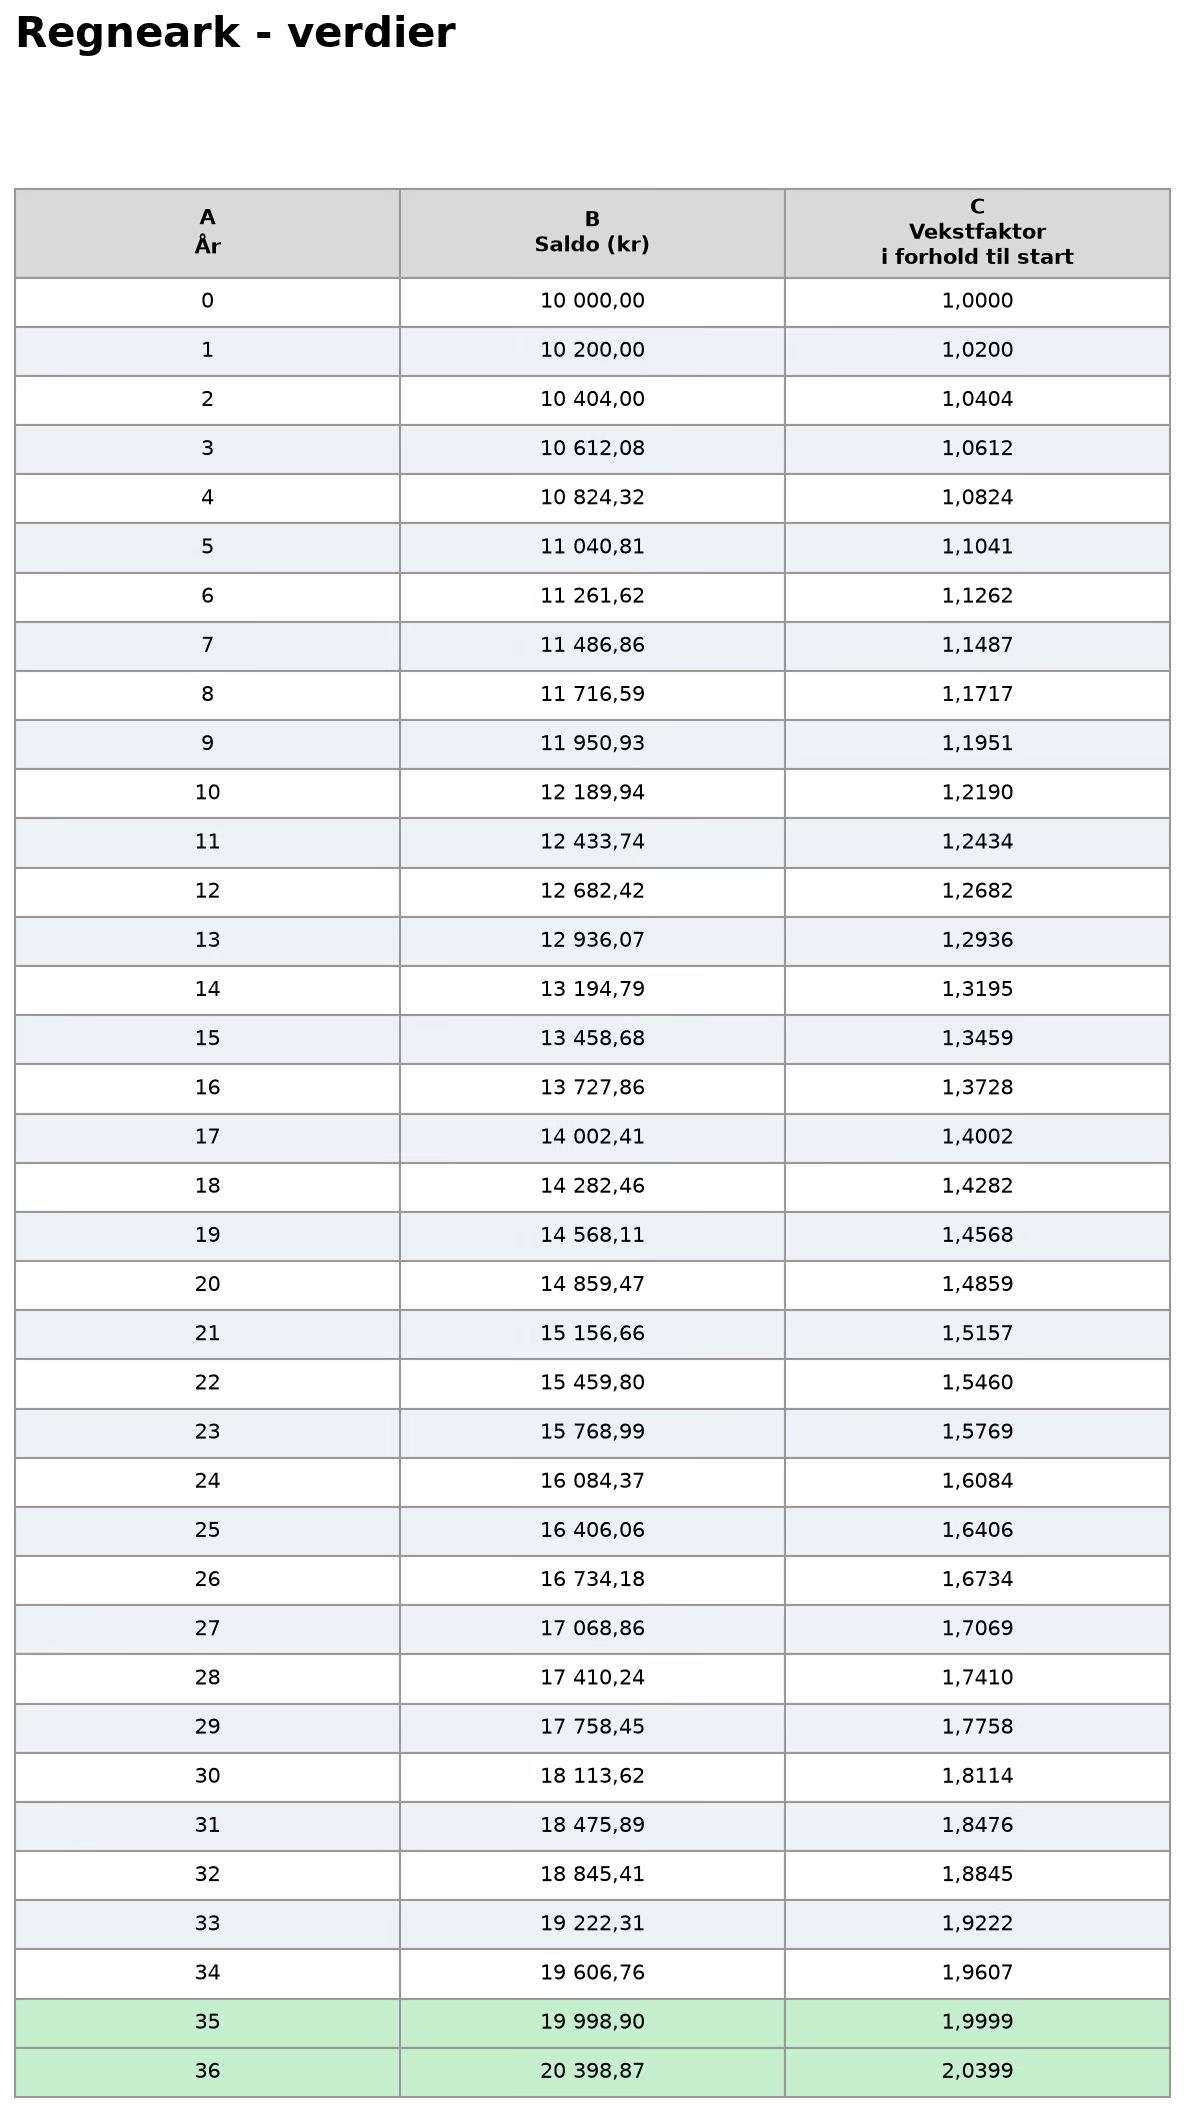
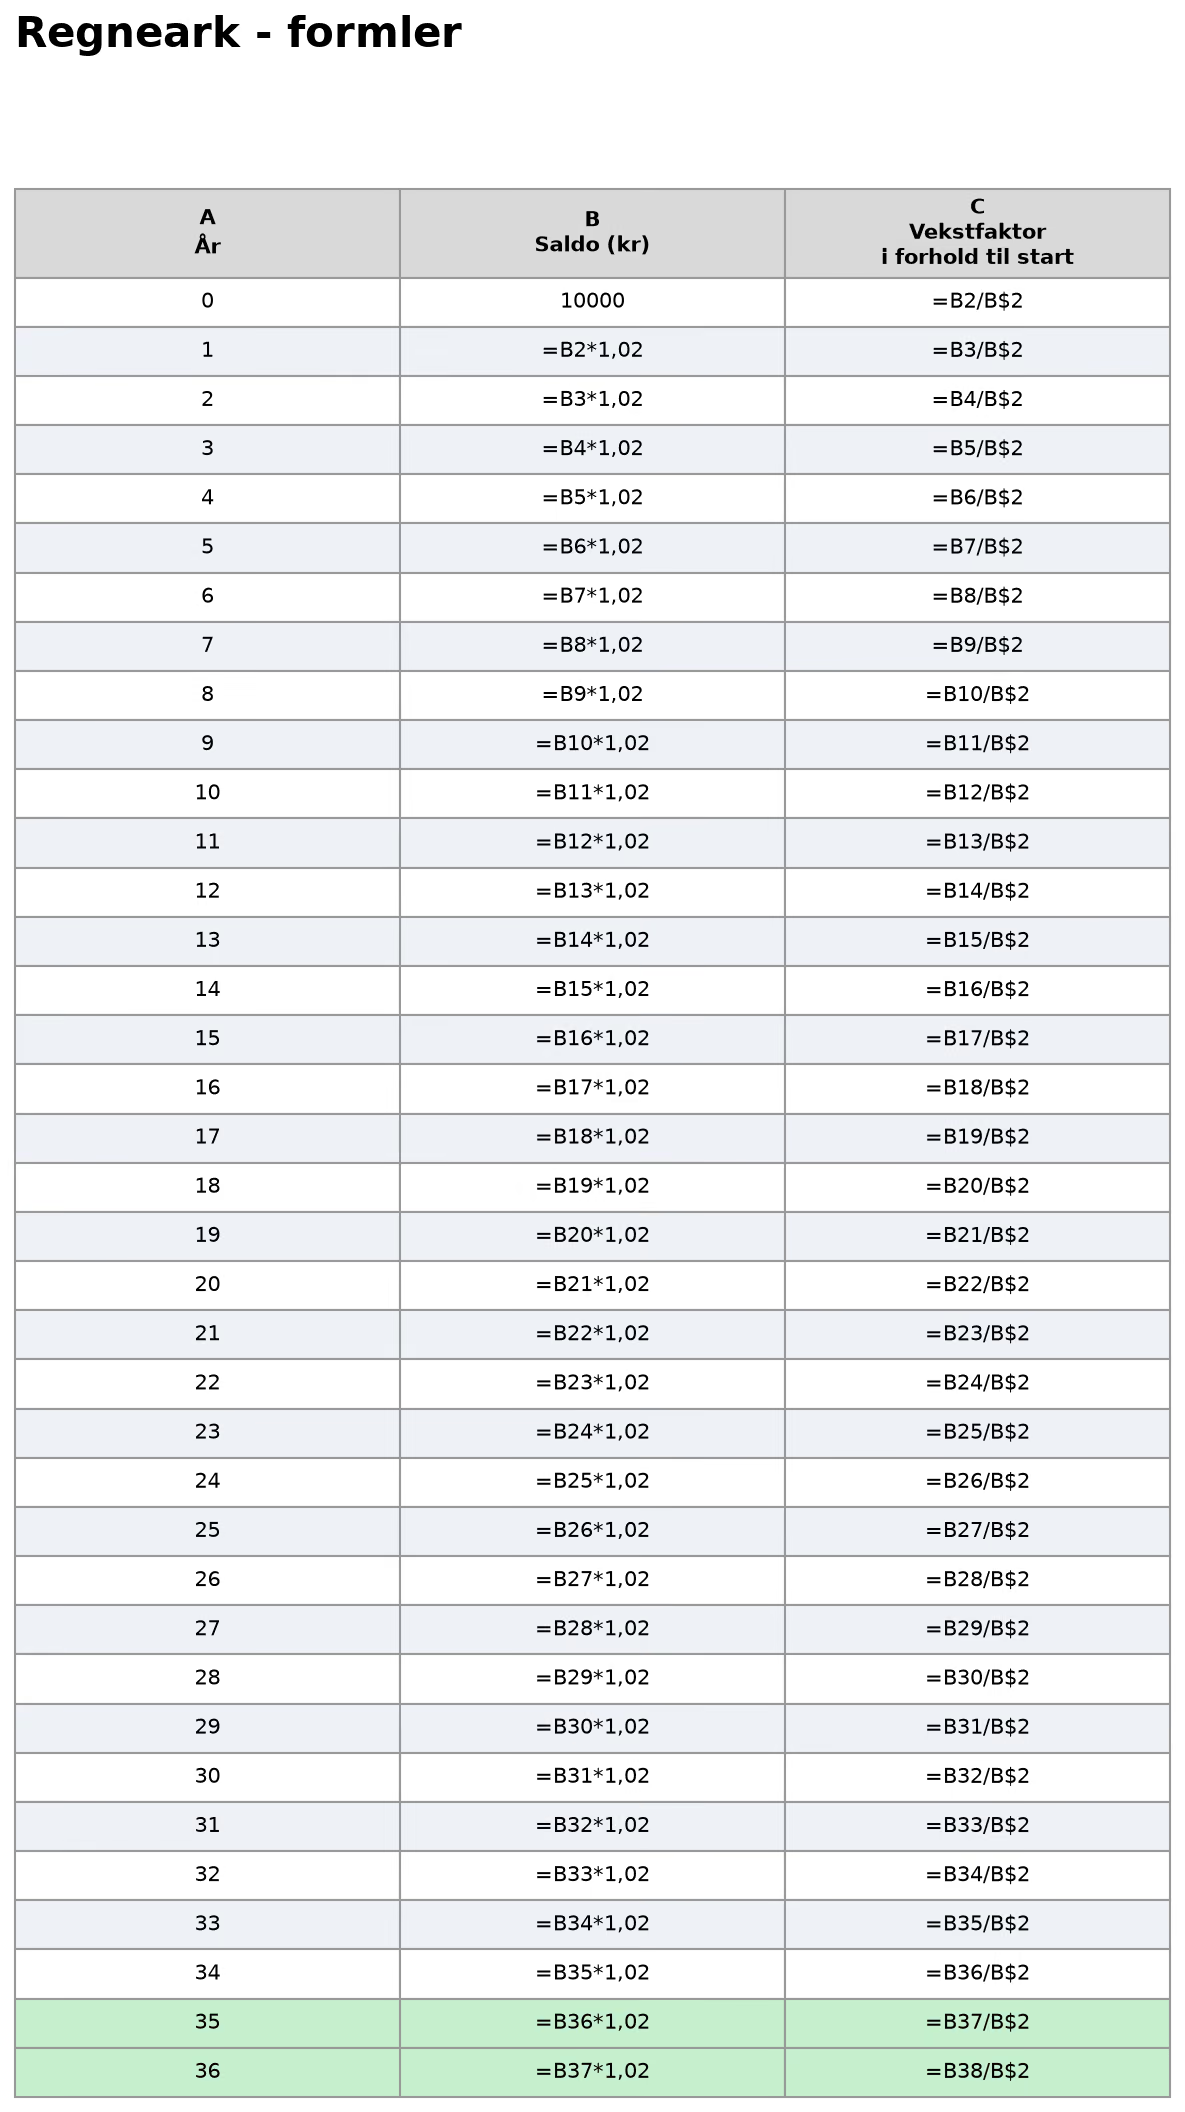
Regneark. Jonas kan sette opp et regneark der kolonne A viser antall år og kolonne B viser saldoen. Startbeløpet legges i celle B2, og i cellene under kopieres formelen «forrige saldo ganger vekstfaktoren»:
A: År
B: Saldo, i første rad (år 0), deretter
C: Vekstfaktor i forhold til startbeløpet, \mathtt{=B\{rad\}/B\
ParseError: Unexpected character: '\' at position 20:
…htt{=B\{rad\}/B\̲2}$
Regnearket med formlene bak beregningene:
Vi ser at vekstfaktoren passerer mellom år (vekstfaktor ) og år (vekstfaktor ). Beløpet er altså ikke helt doblet etter år, men praktisk talt doblet — vi runder av og sier at doblingstiden er om lag år.
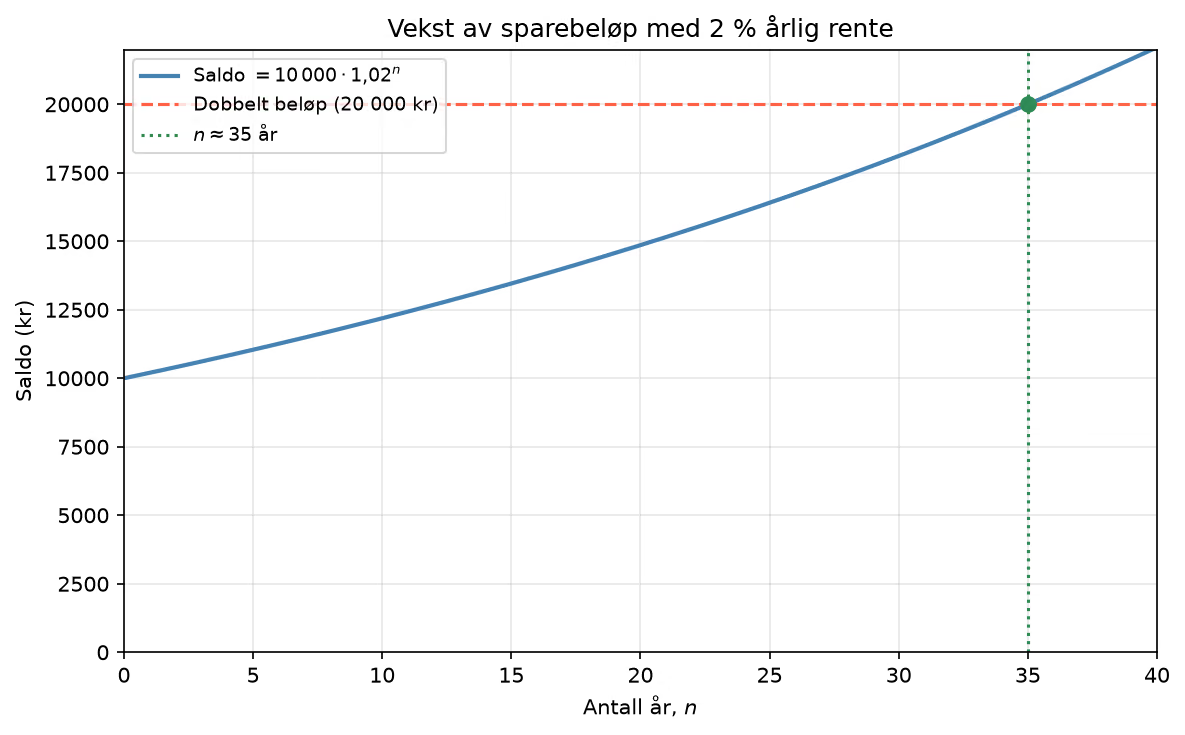
Grafisk framstilling. Margrete kan i stedet tegne grafen til sammen med den vannrette linja (det doble startbeløpet). Skjæringspunktet mellom kurven og linja viser hvor mange år det tar å doble beløpet.
Grafen bekrefter det vi fant i regnearket: kurven krysser linja ved , altså er
b)
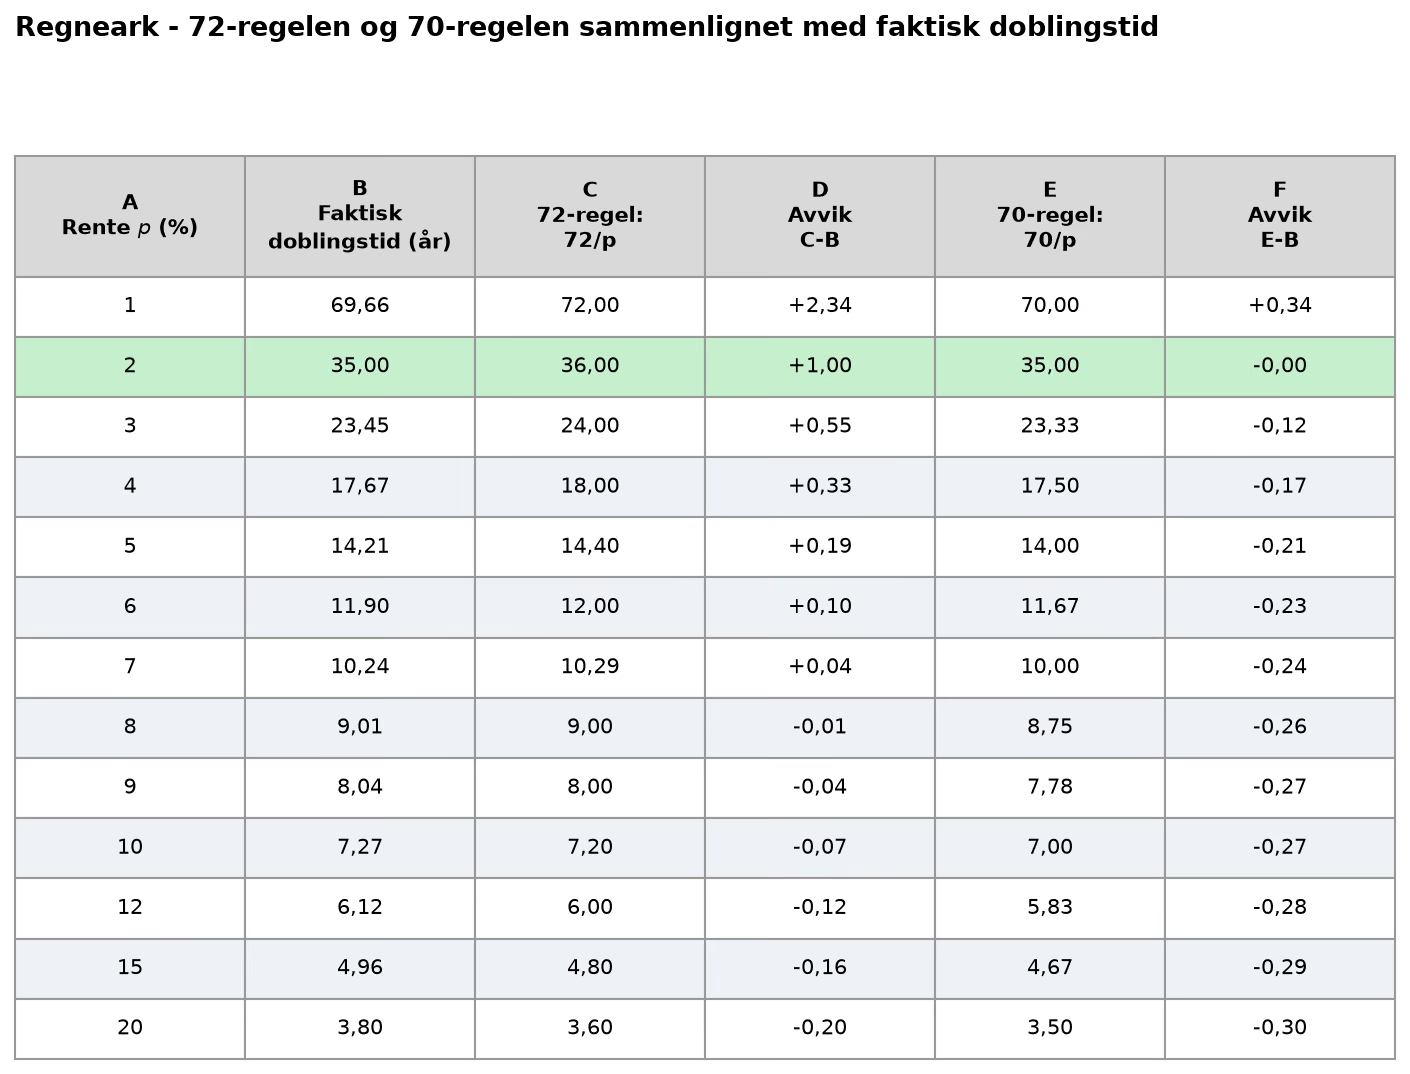
For å undersøke hvor godt -regelen stemmer for andre rentesatser, bygger vi en tilsvarende tabell/graf som i a) for flere ulike rentesatser . For hver rentesats finner vi det året der vekstfaktoren passerer (akkurat som i a)), og interpolerer mellom de to nærmeste årsverdiene for å anslå doblingstiden mer presist. Vi sammenlikner så dette med -regelens anslag, :
Tabellen viser at -regelen stemmer svært godt for rentesatser mellom omtrent og — der er avviket under år. Jo lenger unna dette intervallet rentesatsen er, desto større blir avviket:
for lave rentesatser (under ca. , som er vanlig på en sparekonto) overvurderer -regelen doblingstiden — den gir et for stort antall år,
for høye rentesatser (over ca. ) undervurderer regelen doblingstiden.
For banken sin rente på i oppgaveteksten gir -regelen år mot den faktiske doblingstiden på år — et avvik på år.
c)
Margrete foreslår å bruke i stedet for . Vi legger til en kolonne med i samme tabell (se bilde over, kolonne E og F).
Tabellen viser at -regelen gir et bedre anslag enn -regelen nettopp for lave rentesatser, som – — akkurat det som er typisk for en vanlig sparekonto i banken. Ved rente gir -regelen år, som stemmer nesten perfekt med den faktiske doblingstiden på år, mens -regelen bommer med et helt år.
For høyere rentesatser (over ca. ) er det derimot -regelen som gir det beste anslaget, fordi -regelen da systematisk undervurderer doblingstiden mer og mer jo høyere renta blir.
Konklusjon: i at det kan være lurere å bruke i stedet for — i alle fall så lenge rentesatsen er lav, slik den typisk er på en sparekonto. Skal man derimot regne på f.eks. avkastning på aksjer eller fond, der rentesatsen (avkastningen) gjerne er høyere, er -regelen det beste alternativet.