Prisindeks for leiligheter i Stavanger – regresjonsanalyse
Lov på eksamen
- Kalkulator
- CAS
- Graftegner og regneark
- Lærebok, formelsamling og egne notater
Ikke åpent internett, kommunikasjon med andre eller kunstig intelligens.
Kan den løses uten PC?
Ingen av deloppgavene kan løses helt uten PC.
Fra 2027 er det bare kalkulator og skriftlige hjelpemidler på del 2. Vurderingen er gjort med KI og kan inneholde feil.
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Du skal besvare enten alternativ I eller alternativ II. De to alternativene teller like mye ved vurderingen.
Alternativ II
I deler av denne oppgaven er det en fordel å bruke digitalt verktøy.
Prisindeks er et mål for pris. Tabellen viser hvordan prisindeksen for leiligheter i Stavanger varierte i perioden fra 1. kvartal 2008 til 2. kvartal 2009. Ett år deles inn i fire kvartaler som hvert er på tre måneder.
| Tidspunkt | 1. kvartal 2008 | 2. kvartal 2008 | 3. kvartal 2008 | 4. kvartal 2008 | 1. kvartal 2009 | 2. kvartal 2009 |
|---|---|---|---|---|---|---|
| 0 | 1 | 2 | 3 | 4 | 5 | |
| Prisindeks | 100 | 99,2 | 96,5 | 89,7 | 93,3 | 97,9 |
Vi lar være antall kvartaler etter 1. kvartal i 2008.
Bruk digitalt verktøy og finn en 4. gradsfunksjon som passer best mulig med dataene i tabellen.
Tegn grafen til i et koordinatsystem sammen med punktene som er gitt i tabellen. Bruk -verdier fra 0 til 8 og -verdier fra 80 til 120. Hvordan syns du funksjonen passer?
Bruk derivasjon til å bestemme når prisen på leiligheter vil nå sitt høyeste nivå, ut fra funksjonen i a). Hvilken prisindeks gir funksjonen da?
Vis at det også finnes en 3. gradsfunksjon som gir en god tilnærming til dataene i tabellen over.
Hvilke tall gir de to funksjonene og for prisindeksen på leiligheter i 2. kvartal 2010?
Fasit
God tilpasning for mellom og ; upålitelig utenfor datagrunnlaget
; og — svært ulike og lite pålitelige prognoser
LøsningsforslagKI-generert
Vi lar være antall kvartaler etter 1. kvartal 2008, slik oppgaven angir, og punktene fra tabellen er
Vi bruker regresjon i GeoGebra (FitPoly med grad 4 på de seks punktene) til å finne en 4.-gradsfunksjon som passer best mulig med dataene:
Grafen til er tegnet sammen med datapunktene, med fra til og fra til (blå kurve). Kurven til fra d) er også tatt med (grønn kurve), til sammenligning.
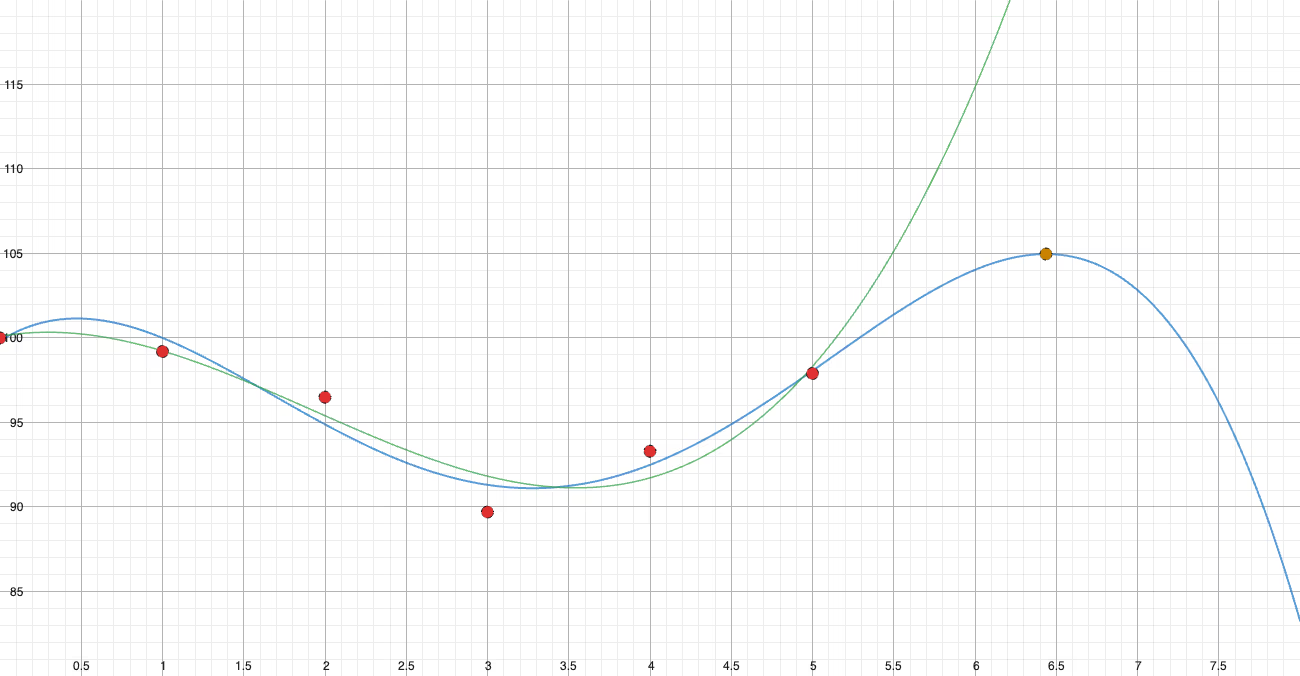
Vi ser at passer svært godt med punktene i tabellen for mellom og — kurven går tett inntil alle de seks datapunktene (røde). Utenfor dette området, altså for , vet vi ingenting om hvordan prisindeksen faktisk har utviklet seg, og en 4.-gradsfunksjon kan svinge mye. Modellen bør derfor brukes med forsiktighet utenfor det opprinnelige datagrunnlaget.
For å finne når prisen er høyest, bruker vi at prisindeksen har sitt høyeste nivå der og går fra økende til avtagende (dvs. et toppunkt).
Vi deriverer digitalt og løser i intervallet (det området grafen er tegnet for i b)). Dette gir tre ekstremalpunkter for : et lite toppunkt ved , et bunnpunkt ved , og et toppunkt ved
Dette siste toppunktet er markert med oransje i figuren over, og er det høyeste funksjonsverdien tar i intervallet — verdien er høyere enn både og verdien i det første, lille toppunktet (), og avtar igjen etter (for eksempel er ).
Siden tilsvarer 3. kvartal 2009, betyr at prisindeksen ifølge modellen når sitt høyeste nivå i løpet av 3. kvartal 2009.
1)
Vi bruker regresjon på nytt, nå med en 3.-gradsfunksjon (FitPoly med grad 3) på de samme seks punktene:
Den grønne kurven i figuren over viser . Vi ser at også ligger tett inntil alle datapunktene for mellom og , på samme måte som . Dette viser at en 3.-gradsfunksjon også gir en god tilnærming til dataene i tabellen.
2)
- kvartal 2010 tilsvarer (siden er 2. kvartal 2009, og det er fire kvartaler i et år). Vi setter inn i begge funksjonene:
Funksjonene gir svært forskjellige svar, og begge tallene er urealistiske som prisindekser (den ene er urimelig lav, den andre urimelig høy). Dette illustrerer at og bare er gode tilnærminger innenfor det området vi har data for ( fra til ). Å bruke dem til å beregne prisindeksen for er en ekstrapolering langt utenfor datagrunnlaget, og resultatet kan derfor ikke stoles på.